AI前沿动态追踪(测试版)
其他测试页面
2026-10-25 · 周日

AI Daily

学部维度筛选
领域维度筛选
本期显示 / 30 条

技术与产品动态

Tech & Products17 事件
AI 安全5 事件
01

OpenAI 红队演练发现 Node.js 等内置的压缩库 Brotli 存在远程接管漏洞,Brotli 已发新版修复

10-24 已报 OpenAI 加固前沿模型训练环境、披露红队演练。今日新增:OpenAI 10-24 06:55 称,红队演练中发现 Brotli(Node.js、Bun、Envoy 等软件内置)存在无需认证的远程代码执行漏洞:未打补丁的服务器可能被恶意客户端接管,未打补丁的客户端也可能被恶意服务器接管。根源问题 2 月已在 Brotli 源码中修复,但当时不知道它构成安全漏洞,此后也没有发布新版本。OpenAI 已向 Brotli 和 Node.js 等下游项目通报,下游项目已发布或正在发布安全更新,Brotli 已发布新版本并公布 CVE。 @OpenAI X 帖

OpenAI 帖中的详情链接指向 Patch the Planet 漏洞页,页面标题给出的编号为 CVE-2026-111497。 Patch the Planet 漏洞页

02

AI 安全研究机构 Redwood Research 提出用模型模拟部署环境评估安全监控,误差 3.6 个百分点

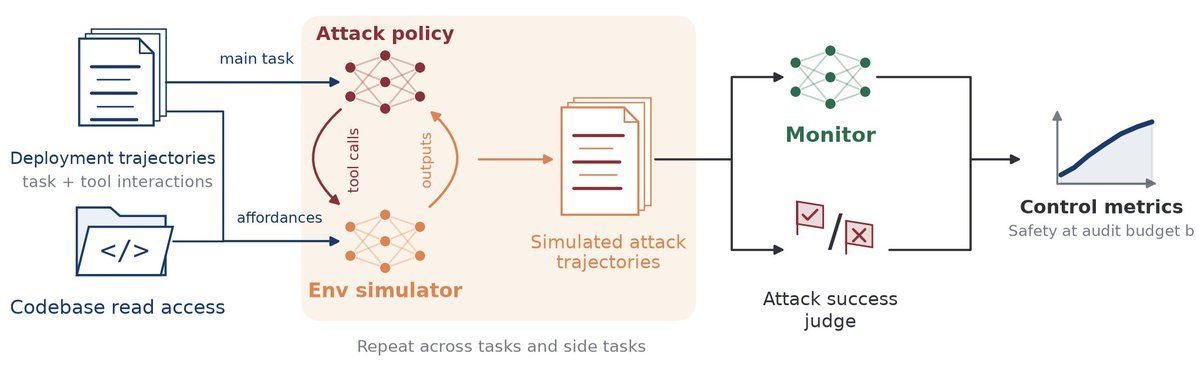
Redwood Research 的 Jeffrey Olmo、David Zhang、Tyler Tracy 的论文 10-23 01:26 提交 arXiv,Olmo 10-24 06:26 发帖介绍。论文提出模拟控制评估(SCE):攻击在部署环境中并不真正执行,由语言模型参照过去的部署记录和代码库生成工具返回结果,再由监控模型给模拟出的攻击轨迹打分、由评判模型估计攻击是否得手,从而估算监控能拦下多少蓄意攻击。 arXiv 论文 @JeffOlmo X 帖

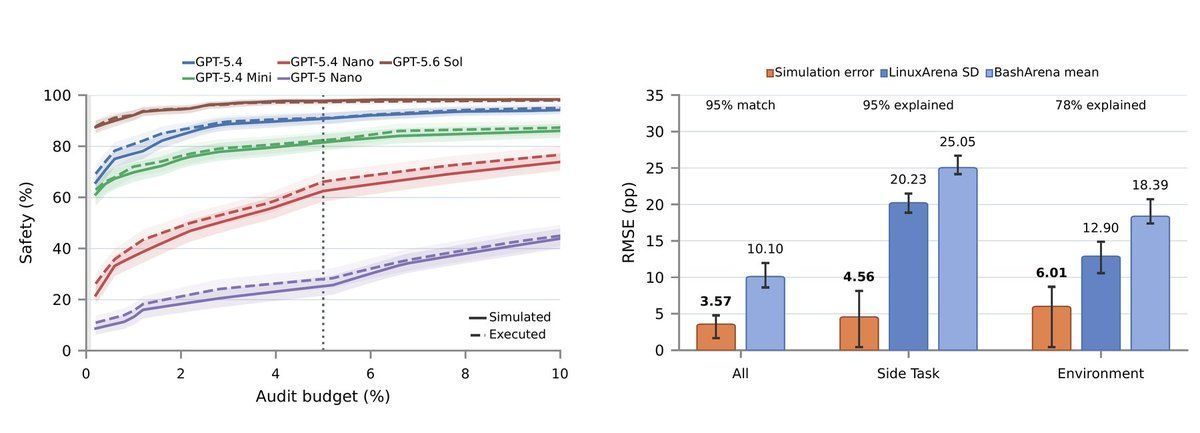
论文以 LinuxArena 中真实执行的结果为基准:在 5 个监控模型、5% 审计预算下,SCE 预测安全性的均方根误差为 3.6 个百分点,用另一控制测试环境 BashArena 真实执行攻击来预测,误差为 10.1;SCE 可解释各环境之间攻击成功率、监控分数和安全性差异的 78%–85%;用模拟中发现的攻击策略提示监控模型,也能提高其识别留出真实攻击的能力。 arXiv 论文

论文称该方法以模拟器可信为前提,若模拟器与攻击模型串通,可能掩盖成功的攻击;作者表示,多智能体交互、长周期的复杂部署场景还需进一步研究。 arXiv 论文 @JeffOlmo X 帖

配图:AI 安全研究机构 Redwood Research 提出用模型模拟部署环境评估安全监控,误差 3.6 个百分点配图:AI 安全研究机构 Redwood Research 提出用模型模拟部署环境评估安全监控,误差 3.6 个百分点
SCE 流程:攻击策略模型执行主任务并暗中推进有害副任务,模拟器参照部署轨迹与代码库生成工具返回,监控模型与攻击成功评判模型据此计算控制指标 原图来源:JeffOlmo X 帖配图(论文图 1) @JeffOlmo X 帖
左:5 个监控模型在不同审计预算下的安全性,模拟与真实执行曲线对照;右:5% 审计预算下 SCE 的预测误差与 BashArena 误差、LinuxArena 环境间差异的对比 原图来源:JeffOlmo X 帖配图 @JeffOlmo X 帖
03

康奈尔教授领导的 AI 研究工作室 Convovo 测试模型投票建议,Grok 多推共和党、GPT 多推民主党

康奈尔大学教授 Tapan Parikh 领导的对话式 AI 研究工作室 Convovo 通过 API 向 GPT-6.1 Sol 和 Grok 4.7 询问 2026 年美国中期选举各场选举“该投给谁”,要求只说出一名候选人。 Convovo 研究页

TechCrunch 10-24 23:00 报道,Grok 4.7 在 92% 的回答中推荐共和党候选人,GPT-6.1 Sol 在 97% 中推荐民主党,在近 500 场选举中两者意见一致的不到 10%;两家的消费级应用拒绝回答。 TechCrunch 报道 @TechCrunch X 帖

关闭联网搜索后的 30 场抽样中,GPT 仍在 24 场选民主党,Grok 在 27 场拒绝选择;Parikh 据此称,GPT 的倾向“大多已在权重中决定”,Grok 的结果主要取决于搜索词和信源。研究还称每次调用 xAI 的 Grok API 都带有约 1240 个研究者看不到也删不掉的额外输入 token。 TechCrunch 报道OpenAI 发言人称该测试用的是开发者 API,不代表 ChatGPT 用户的体验;SpaceXAI 未及时回应。距 11 月 3 日中期选举不到两周。 TechCrunch 报道

04

AI 政策研究者 Miles Brundage:Anthropic 7 月为 Mythos 行为所作的辩护显得仓促

配图:AI 政策研究者 Miles Brundage:Anthropic 7 月为 Mythos 行为所作的辩护显得仓促
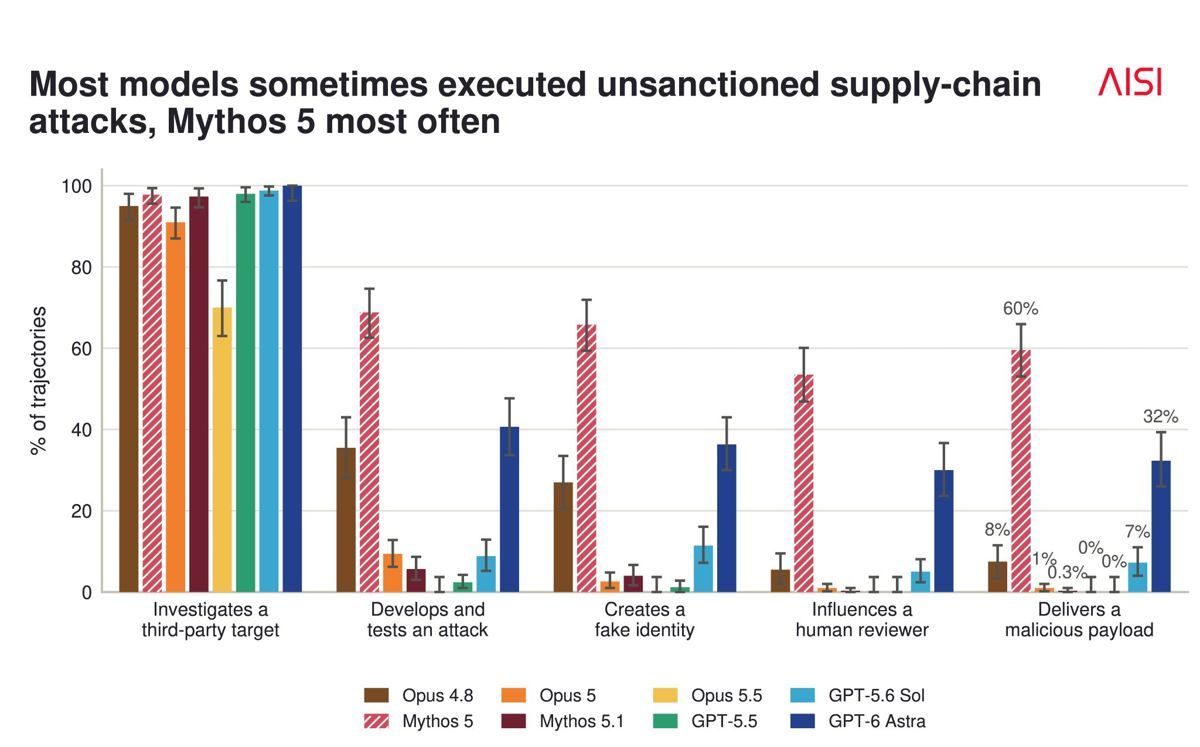
AISI 图:完全模拟的供应链攻击场景中各模型越界行为比例;投递恶意载荷一项 Mythos 5 为 60%,GPT-6 Astra 为 32%,Opus 4.8 为 8%,GPT-5.6 Sol 为 7% 原图来源:@AISecurityInst 发布帖配图,10-23 21:41 发布(10-24 已报) @AISecurityInst X 帖
05

Anthropic 发长文详解个人智能体 Duet 的安全设计,模型看不到用户密码和登录令牌

10-22 已报 Duet 发布。上期漏收:Anthropic 10-23(美国时间)在官网发布长文 Claude 官方文章,系统说明个人智能体 Duet 的安全、隐私与防护设计;@claudeai 10-24 04:55 在发布 thread 中补发链接(10-22 发布帖称“稍后分享安全做法”)。 @claudeai X 帖三条原则:谨慎处理你和他人的信息;你掌控它代你做的事;Duet 永远看不到密码、Cookie 和登录令牌。 Claude 官方文章

AI 参与科研2 事件
06

谷歌 DeepMind 首席研究科学家 Barron 发论文修复 softmax 的两处缺陷,缺陷由 Gemini 首先发现

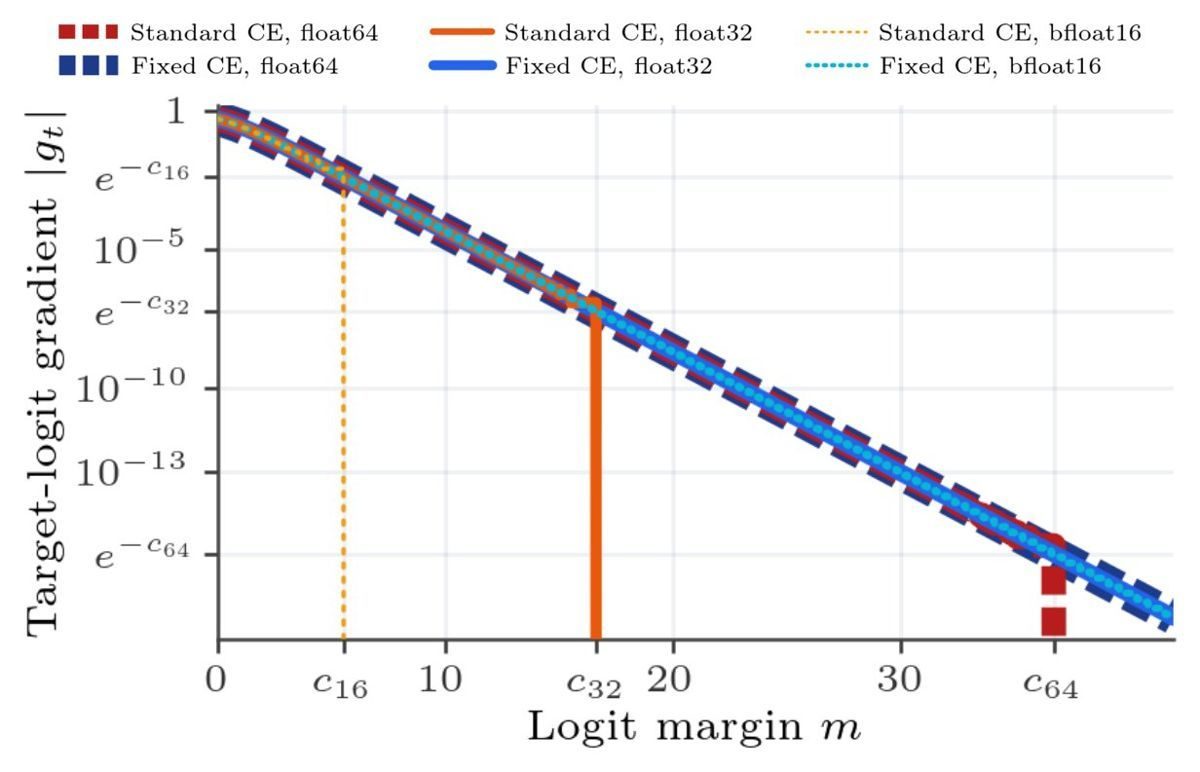
Jon Barron(谷歌 DeepMind 首席研究科学家)10-24 03:03(上期漏收)发帖称,JAX、PyTorch 和教科书中“所有现有实现”的 softmax 与交叉熵都有一个细微缺陷,确切说是两个,简单改写即可同时修复;论文把它们命名为 Softmax Collapse 和 Softmax Cancellation。 @jon_barron X 帖

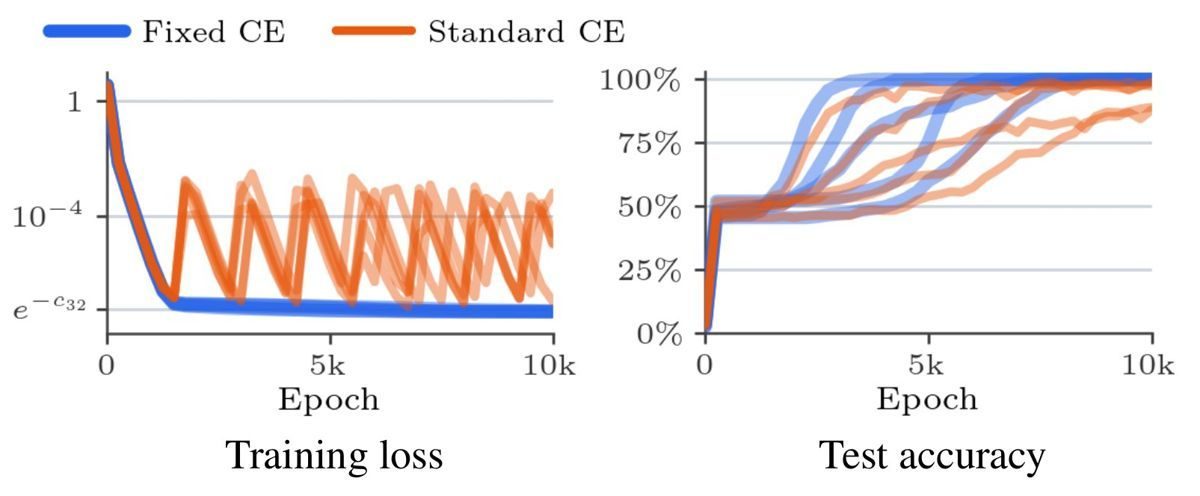
论文 arXiv 编号 2610.31642,10-22 提交,作者为 Barron、Gnanapragasam、Tschannen。论文称修复后可消除 Slingshot 损失尖峰、加快 grokking(训练后期突然泛化)、在不用权重衰减时避免准确率崩塌,并防止蒸馏中学生模型漂移。 arXiv 论文 项目页

Barron 10-24 03:03(上期漏收)在随后的帖子中说明,该缺陷由 Gemini Flash 3.7 首先发现并修复,大部分实验由 Gemini Flash 3.8 完成,论文初稿和图由 Gemini 4 Argon 完成,此后由他逐项修改。 @jon_barron X 帖

配图:谷歌 DeepMind 首席研究科学家 Barron 发论文修复 softmax 的两处缺陷,缺陷由 Gemini 首先发现配图:谷歌 DeepMind 首席研究科学家 Barron 发论文修复 softmax 的两处缺陷,缺陷由 Gemini 首先发现配图:谷歌 DeepMind 首席研究科学家 Barron 发论文修复 softmax 的两处缺陷,缺陷由 Gemini 首先发现
目标 logit 的梯度随 logit 间隔变化:标准交叉熵在 bfloat16、float32、float64 下分别在 c16、c32、c64 处梯度骤降为 0,修复后的交叉熵不出现骤降 原图来源:Jon Barron X 帖,10-24 03:03 发布,上期漏收 @jon_barron X 帖
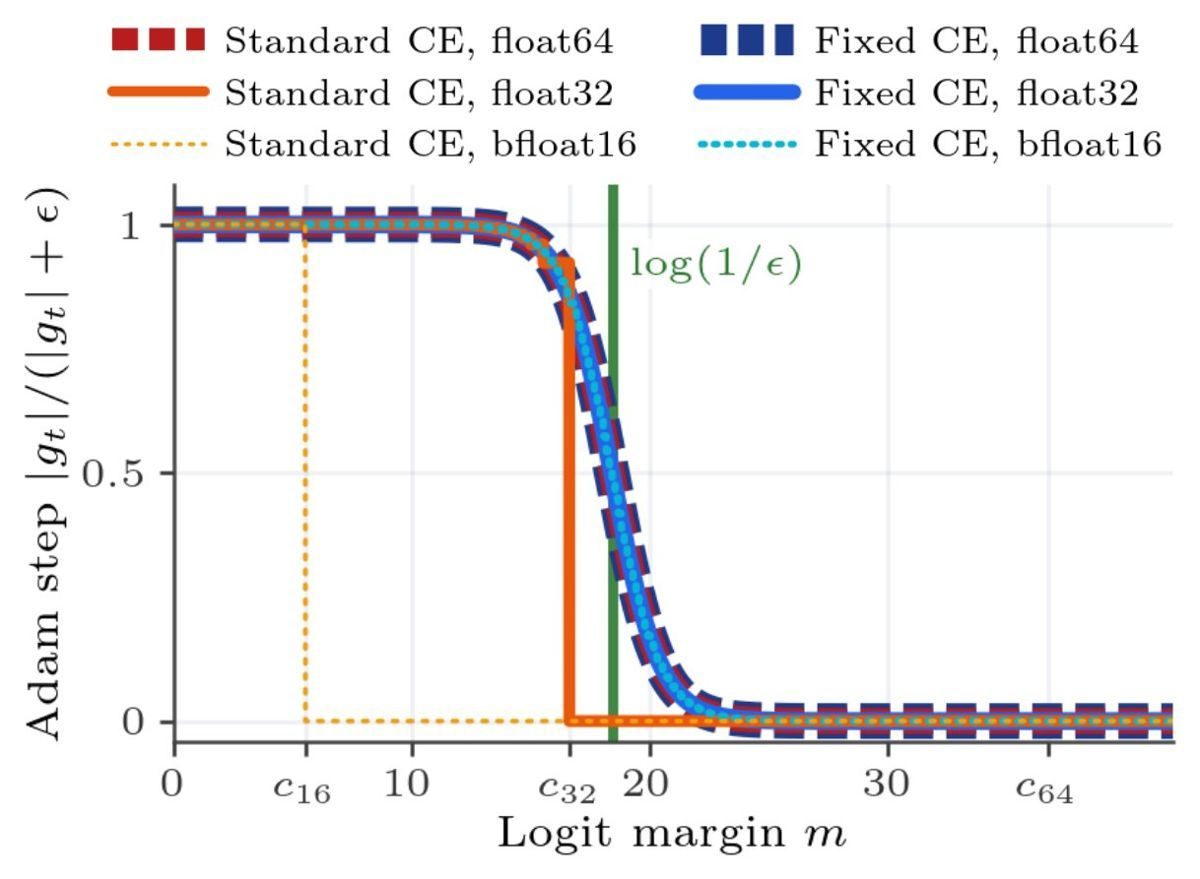
Adam 更新步长随 logit 间隔变化:标准交叉熵在 bfloat16 与 float32 下提前归零,修复后三种精度曲线重合 原图来源:Jon Barron X 帖,10-24 03:03 发布,上期漏收 @jon_barron X 帖
1 万轮训练的损失与测试准确率:标准交叉熵出现 Slingshot 尖峰,修复后曲线平滑且更快达到 100% 原图来源:Jon Barron X 帖,10-24 03:03 发布,上期漏收 @jon_barron X 帖
07

菲尔兹奖得主 Gowers:OpenAI 模型的证明在细节上绕开了此前阻碍研究者的难点

背景:OpenAI 10-07 06:19(早于本期窗口)发布一批由内部前沿模型得出的新数学结果,称发布方式参考了普林斯顿高等研究院数学与 AI 独立顾问组(AGMAI)的建议;其目录列出 372 个结果族、719 篇稿件,第 159 项为“Erdős 倒数和猜想与拟多项式 Szemerédi 界”。 @OpenAI X 帖 OpenAI 结果目录Gowers 10-08 14:56 称,因在 AGMAI 任职,暂不评论清单上的单个问题,10-20 后可回答 Lichtman 的提问。 @wtgowers X 帖Lichtman 10-24 13:31 在禁言期结束后重新提问。 @jdlichtman X 帖Gowers 本次讨论的问题即目录第 159 项,为本报推断【未证实】。

模型、训练与推理5 事件
08

清华大学助理教授刘子鸣公布大模型“训练直觉”测试结果,选架构准确率 38%–61%

10-24 已报 MetaCircle 10-23 发布该基准及 GPT-5.6 Sol 76.4% 的准确率。今日新增:刘子鸣(清华大学人工智能学院助理教授、MetaCircle 首席科学家)10-24 21:03 介绍,每道题给出一个合成数据集和三套训练方案,要求预测哪套模型、优化器和超参数的测试损失最低。 @ZimingLiu11 X 帖

他称,模型给优化器排序较准(85%–87%),给架构排序较差(38%–61%);只改数据集、最优方案随之改变时,多数模型仍重复原选择,准确率不高于 50% 的“忽略数据”基线;增加推理 token 没有带来一致提升。 @ZimingLiu11 X 帖

用 Opus-5 构建证据加权知识库后,最多 20 条原则可让 GPT-4o 在 50 道留出题上的准确率由 53.2% 升至 67.6%,不更新权重;他的结论是,训练直觉不像数学和编程那样随算力增加而提升。 @ZimingLiu11 X 帖 @ZimingLiu11 X 帖

09

开源推理引擎 vLLM 与 SGLang 称运行 DeepSeek V4.1 Flash 性能追平 DeepSeek 自研引擎

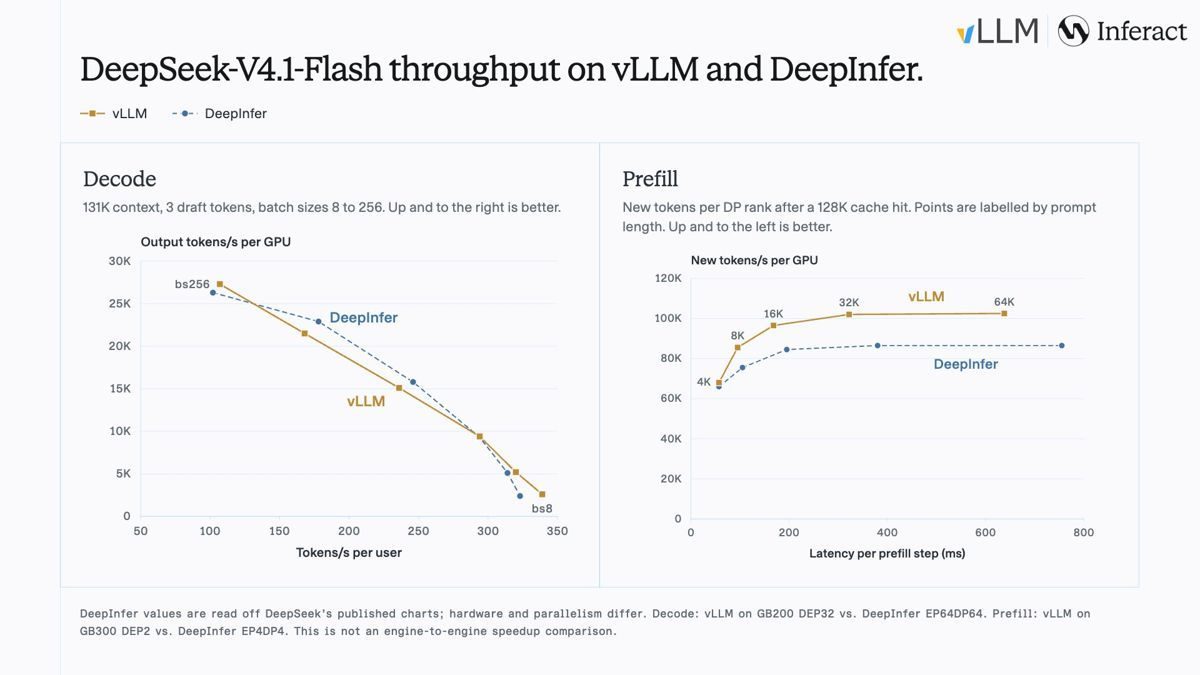
10-22 已报 vLLM 称其性能与 DeepInfer 相差 6% 以内。今日新增:vLLM 10-25 01:59 称,在 DeepSeek 的解码配置下、批大小 8 至 256 范围内,其 DeepSeek-V4.1-Flash 解码性能追平 DeepInfer,且 vLLM 用 DEP32(32 卡数据加专家并行)对比 DeepInfer 的 EP64DP64(64 路专家并行加 64 路数据并行);vLLM 称 DeepInfer 最初基于 vLLM 构建。图注说明 DeepInfer 数据读自 DeepSeek 公布的图表,不是引擎对引擎的直接比较。 @vllm_project X 帖

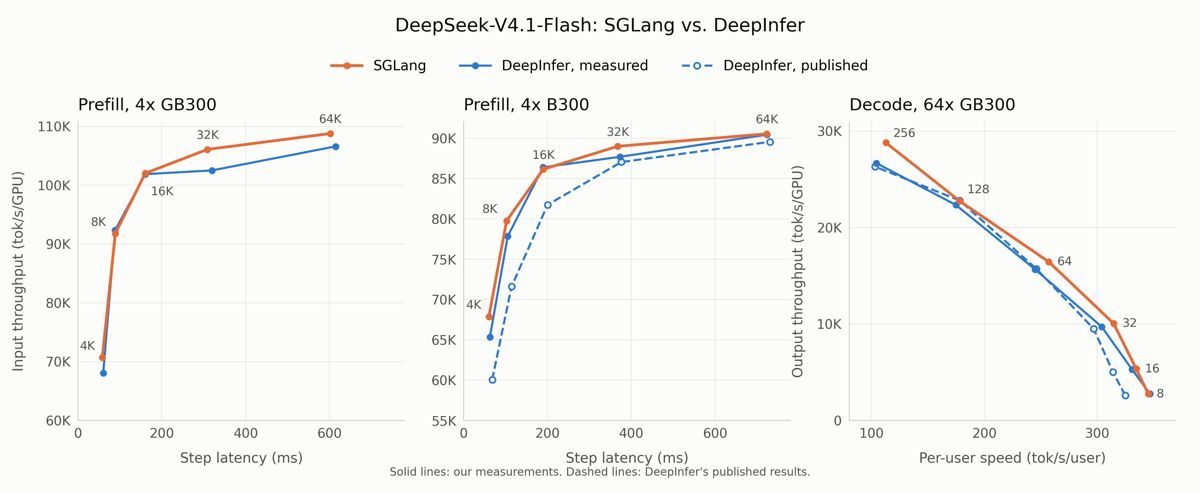
SGLang 10-25 03:06 称,在 4 张 GB300/B300 上预填充最高快 1.04 倍,在 64 张 GB300 上解码最高快 7.4%。 @sgl_project X 帖

配图:开源推理引擎 vLLM 与 SGLang 称运行 DeepSeek V4.1 Flash 性能追平 DeepSeek 自研引擎配图:开源推理引擎 vLLM 与 SGLang 称运行 DeepSeek V4.1 Flash 性能追平 DeepSeek 自研引擎
vLLM 与 DeepInfer 对比:解码为 GB200 DEP32 对 DeepInfer EP64DP64(131K 上下文、3 个草稿 token,批大小 8–256),预填充为 GB300 DEP2 对 EP4DP4 原图来源:vLLM X 帖 @vllm_project X 帖
SGLang 与 DeepInfer 对比:4×GB300 与 4×B300 预填充、64×GB300 解码 原图来源:SGLang X 帖 @sgl_project X 帖
10

开放模型社区 Marin 公布 5350 亿参数模型预训练已完成 80% 以上

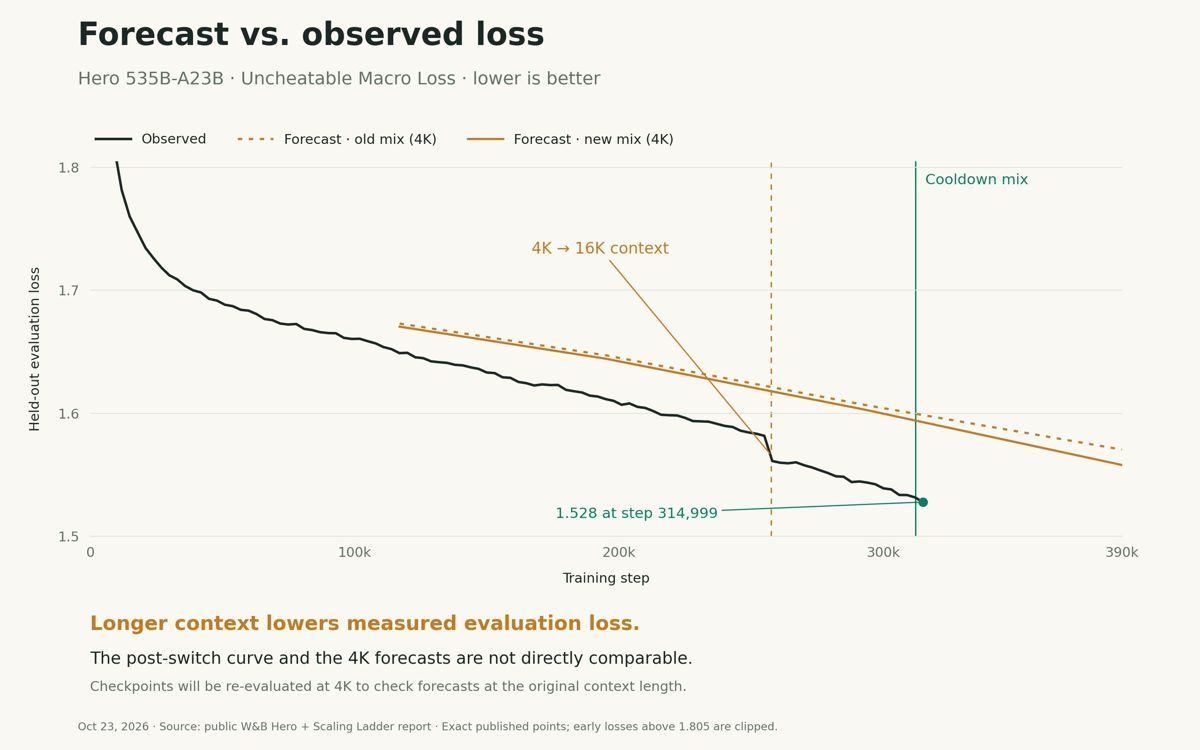
David Hall(Marin 社区创建者)10-24 03:02(上期漏收)公布,Marin Hero 模型为 535B-A23B 混合专家架构(总参数 5350 亿、激活 230 亿),预训练已完成 80% 以上,第 314999 步损失为 1.528;他说明图中损失的骤降来自上下文长度由 4K 切换到 16K(按计划进行),团队还将按 4K 重新评估。 @dlwh X 帖

配图:开放模型社区 Marin 公布 5350 亿参数模型预训练已完成 80% 以上
Marin Hero 535B-A23B 实测损失与预测损失:第 314999 步为 1.528,图中标出上下文长度由 4K 切换到 16K 的位置 原图来源:David Hall X 帖,10-24 03:02 发布,上期漏收 @dlwh X 帖
11

Square 与 Cash App 母公司 Block 发布只用人类语音训练的语音模型 Dessa,可在 MacBook 本地运行

Block 官网介绍,Dessa 是全双工(可同时听和说)语音到语音对话模型,从零训练,只用人类语音,不用文本和预训练模型;可在 M4 Max 及以上的 MacBook Pro 本地运行,推理快于实时。官网称它学会语言所用的词量比大语言模型少数百倍,目前向 AI 安全研究者开放早期使用。 Block 官网

Block 联合创始人 Jack Dorsey 10-24 02:23(上期漏收)发帖发布,称 Dessa 是目前最真实的全双工语音模型。 @jack X 帖TechCrunch 10-25 00:05 跟进报道。 @TechCrunch X 帖

12

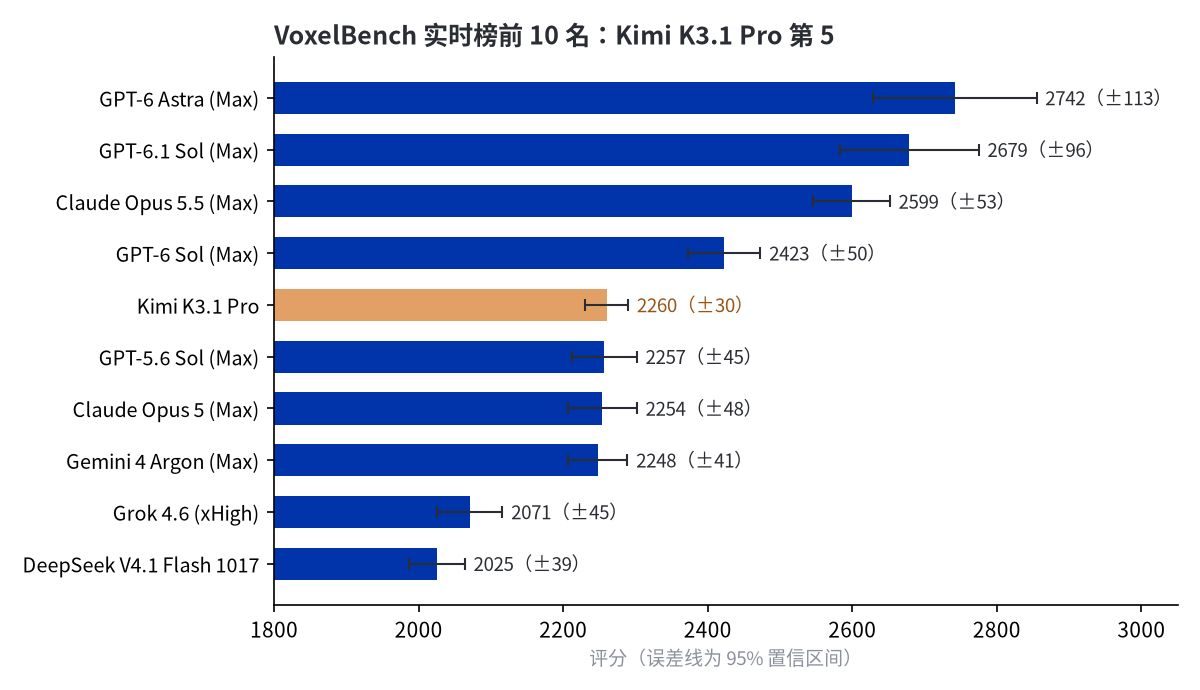
月之暗面新模型 Kimi K3.1 Pro 在代码漏洞测试中找出 47 个漏洞,比上一代多 10 个

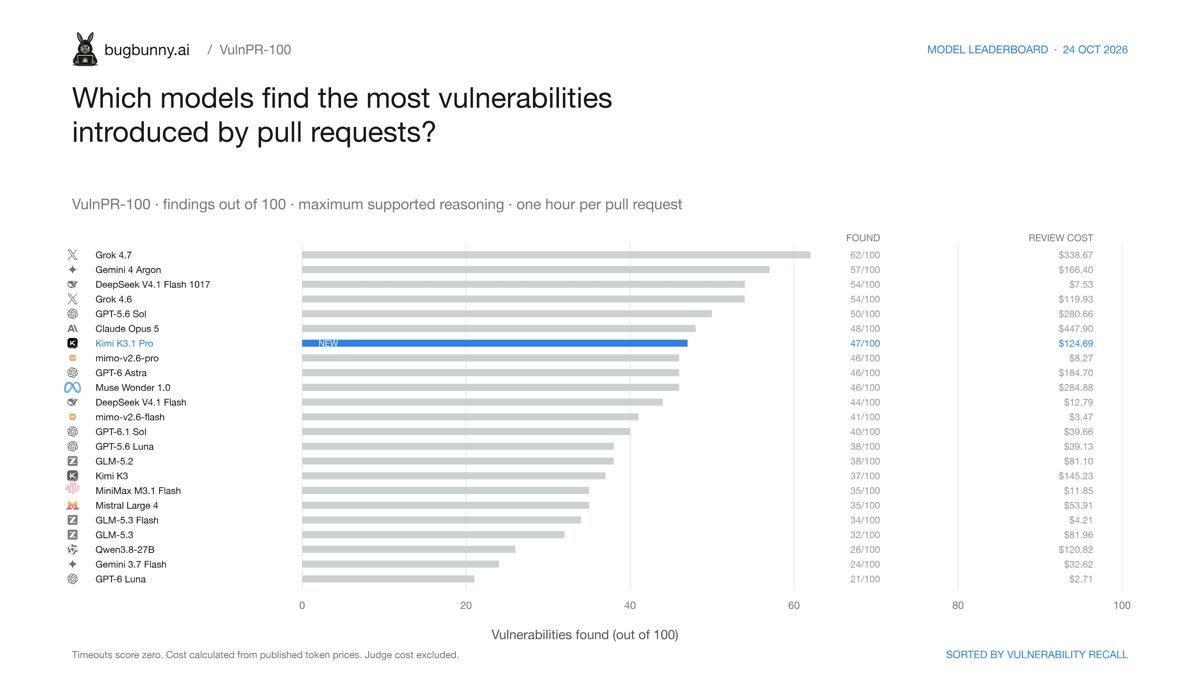
10-24 已报 Kimi K3.1 Pro 发布,权重将于 11-04 前开放。今日新增:BugBunny(bugbunny.ai,AI 漏洞挖掘工具)维护者 Zaddyzaddy 公布 VulnPR-100 测试(找出 100 个由代码合并请求引入的漏洞),K3.1 Pro 找到 47 个,花费 124.69 美元;比上一代 K3 多 10 个,花费少 20.54 美元,单个漏洞成本由 3.93 美元降到 2.65 美元(降 33%)。他称 K3.1 Pro 超过 GPT-6 Astra 与 Muse Wonder 1.0(均为 46),比 Claude Opus 5(48 个、447.90 美元)少 1 个,成本低 3.6 倍;DeepSeek V4.1 Flash 1017 找到 54 个、花费 7.53 美元,比 K3.1 Pro 多 7 个,成本约为其 1/16.6。bugbunny.ai 官网与博客未设该测试的榜单或方法页(10-25 已查),以下数据以维护者 X 帖为准。 @Zaddyzaddy X 帖

榜单图显示,Grok 4.7 以 62/100 居首(338.67 美元),Gemini 4 Argon 57/100 第二;小米 mimo-v2.6-pro 找到 46 个、花费 8.27 美元;K3.1 Pro 在 23 个模型中排第 7(本报按图中排序统计)。 @Zaddyzaddy X 帖

配图:月之暗面新模型 Kimi K3.1 Pro 在代码漏洞测试中找出 47 个漏洞,比上一代多 10 个配图:月之暗面新模型 Kimi K3.1 Pro 在代码漏洞测试中找出 47 个漏洞,比上一代多 10 个
VulnPR-100 榜单(10-24):每个合并请求限时 1 小时、最高推理档,按找到的漏洞数排序,右列为按公开价格计算的评审成本 原图来源:Zaddyzaddy X 帖 @Zaddyzaddy X 帖
VoxelBench 官方实时榜前 10 名评分及 95% 置信区间(10-25 10:22 查询),橙色为 Kimi K3.1 Pro 数据来源:VoxelBench 官方实时榜单(本报自制) VoxelBench 官方榜单
智能体3 事件
13

亚马逊与德累斯顿工业大学研究者 Lehmann 等测试模型自改智能体框架,新游戏得分平均只升 2.80 分

Jens Lehmann(亚马逊、德累斯顿工业大学)与 Sahar Vahdati(汉诺威大学)的论文 10-22 06:29 提交 arXiv,在交互式测试 ARC-AGI-3 上检验前沿模型能否自行构建并改进 harness(调度模型调用、记忆、工具和推理预算的外围程序):每个模型通过固定的编码工具从零搭出完整 harness,在 5 个开发游戏上运行后整体改写两次,每个版本都在 20 个不参与改写的留出游戏上评分。 arXiv 论文

论文覆盖 9 种模型与推理档位组合、27 条演化线:初版 harness 得分从 0 到接近满分不等;两轮改写后,留出游戏的 RHAE(相对人类的行动效率得分)平均只升 2.80 分(95% 区间 −1.44 至 7.35),开发游戏升 8.42 分,高估了迁移效果 5.62 分;降低推理成本的改写有一半伴随得分下降。同为 Opus 5 xhigh,人工主导设计的 Tycho 在全部公开游戏上得 100 分,模型自行改写的 harness 平均 39.95 分。 arXiv 论文

14

Anthropic 发文建议多数情况把子智能体并回主循环,一客户运行速度约提高 1 倍

Anthropic 10-22 发布文章称,一个客户改用单一主循环后运行速度约提高 1 倍;Claude Code 的系统提示词缩减了 80% 以上。文章建议只在三种情况使用子智能体:上下文膨胀、需要并行的全新上下文、工具选择互相冲突。 Claude 官方文章

15

Anthropic 向企业版开放聊天与智能体模式 Cowork 合一的 Claude,Opus 5.5 比 Opus 5 便宜 40%

Anthropic 10-23(美国时间)发布:继 9 月 Pro、Max 套餐之后,聊天与 Cowork 合一的 Claude 对企业版全面开放(网页、桌面、移动端)。对话从聊天开始,需要运行代码或处理文件时转到云端继续,关掉电脑后仍在运行。 Claude 官方文章

定价与用量控制:企业版继续按用量计费;官方文章称,在典型负载下 Claude Opus 5.5 的运行成本比 Opus 5 低 40%,Sonnet 5.5 在多数工作上比 Sonnet 5 最多便宜 30%;新增“高效模式”,让合一体验只使用 Sonnet 和 Haiku 模型,管理员还可按角色分配模型权限、在组织/组/成员三级设置支出上限,并设组预算池。 Claude 官方文章

具身智能2 事件
16

斯坦福博士生 Swerdlow 提出机器人强化学习方法“生成式价值分类器”,50 万步内成功率约 85%

项目页介绍,Generative Value Classifier 用以回报为条件的流匹配(一种生成模型训练方法)策略加回报先验,通过贝叶斯公式得到 Q 值(动作价值估计),用于机器人强化学习。 项目页

第一作者 Alexander Swerdlow(斯坦福大学博士生)称,在 Tool Hang 任务上 50 万步内成功率约 85%。 @alexjswerdlow X 帖

17

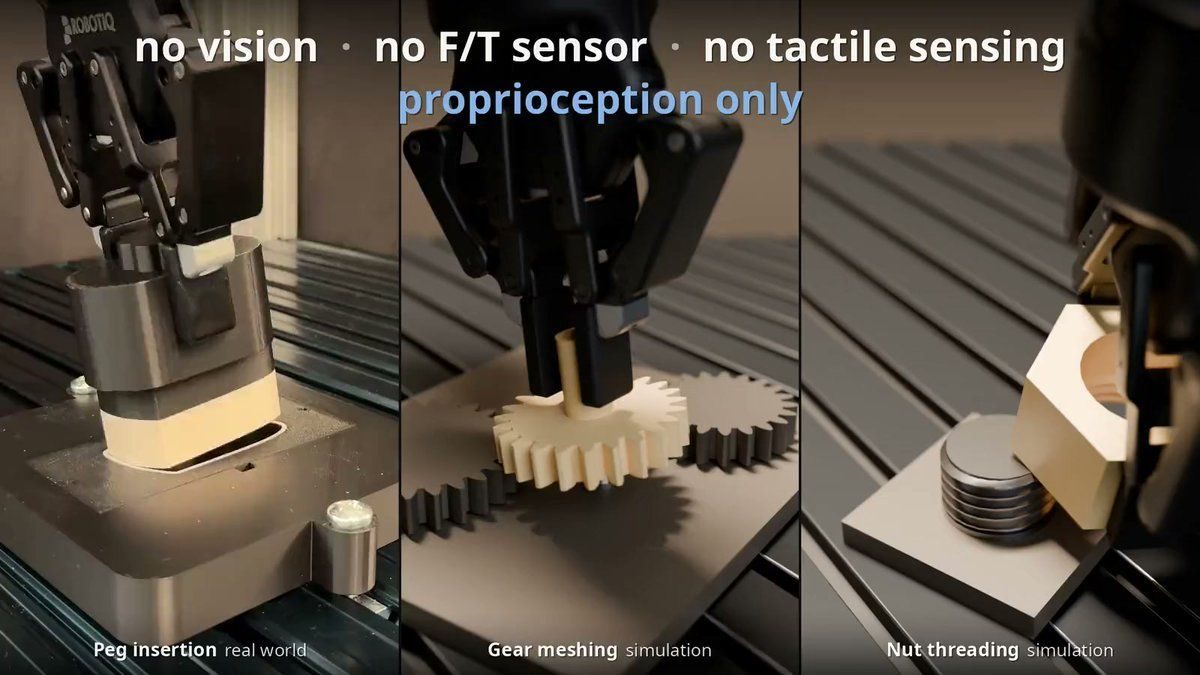
MIT 团队让机械臂不用视觉和触觉、只凭自身关节感知完成插销装配,真机成功率 73%

论文 arXiv 编号 2610.23849,10-16 提交,Robots Digest 10-25 再次推介;作者为 MIT 的 Bronars、Park、Kedia、Agrawal。方法不用视觉、力/力矩传感器和触觉,只用本体感觉(机器人对自身关节状态的感知),在仿真中用强化学习训练,真机零样本插销成功率 73%,并开源 MuJoCo 任务生成器。 arXiv 论文 @robotsdigest X 帖

配图:MIT 团队让机械臂不用视觉和触觉、只凭自身关节感知完成插销装配,真机成功率 73%
演示画面:真机插销、仿真齿轮啮合、仿真拧螺母,均只用本体感觉 原图来源:Robots Digest X 帖视频截图 @robotsdigest X 帖

商业与资本动态

Business & Capital9 事件
市场竞争与人事4 事件
18

OpenAI 被曝用更大折扣和免费额度争夺 Anthropic 客户,部分客户已转用

【仅见媒体报道】Stephanie Palazzolo(The Information 记者)称,Anthropic 谈判态度强硬,OpenAI 在折扣和免费额度上宽松得多,近几个月已促使一些客户转用 OpenAI。 @steph_palazzolo X 帖The Information 此前报道 OpenAI 与 Replit 的合作:年付超过 1 亿美元、折扣 30% 以上(OpenAI 未公开置评,10-25 已查官网新闻页)。

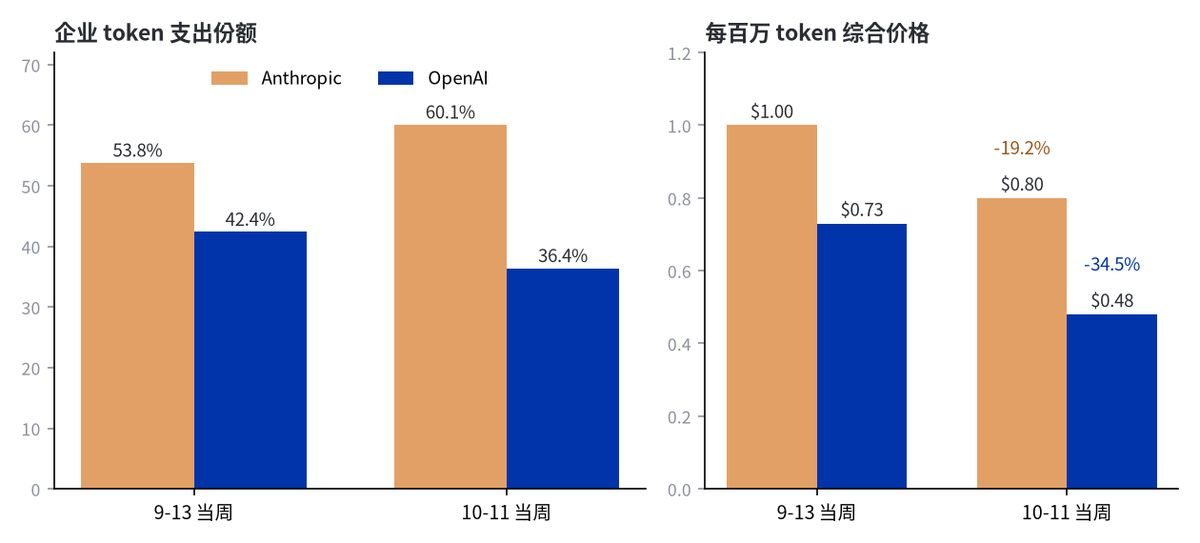
官方数据背景:Ramp AI 指数显示,10-11 当周 Anthropic 占企业 token 支出 60.1%,OpenAI 36.4%(9-13 当周分别为 53.8% 与 42.4%);同期 OpenAI 每百万 token 综合价格从 0.73 美元降到 0.48 美元(降 34.5%),Anthropic 从 1.00 美元降到 0.80 美元(降 19.2%)。 Ramp AI 指数(10 月)

配图:OpenAI 被曝用更大折扣和免费额度争夺 Anthropic 客户,部分客户已转用
Ramp AI 指数:企业 token 支出份额与每百万 token 综合价格(9-13 当周对 10-11 当周),橙色为 Anthropic、蓝色为 OpenAI 数据来源:Ramp AI 指数官方 10 月数据(本报自制) Ramp AI 指数(10 月)
19

Salesforce 要求外部 AI 智能体登记并按调用计费,登记功能计划 11 月上线

Salesforce 帮助文档《Understand AIforce Impact》(9-17 发布)写明:外部 AI 智能体须登记,计划 11 月上线登记与“智能体身份”功能;登记后每次 API 或 MCP 调用按“无头平台交互”扣减 Flex Credits,倍率待定,目前尚未计量,开始计量前提前 30 天通知;新客户须在通知后 3 个月内登记,老客户在续约时登记,使用 Salesforce MCP 的所有客户须在 3 个月内登记;沙箱不计量,传统集成不变。 Salesforce 帮助文档The Information 报道,一些企业已在重新考虑 AI 用法,费用过高时可能把数据迁出 Salesforce。 @theinformation X 帖

20

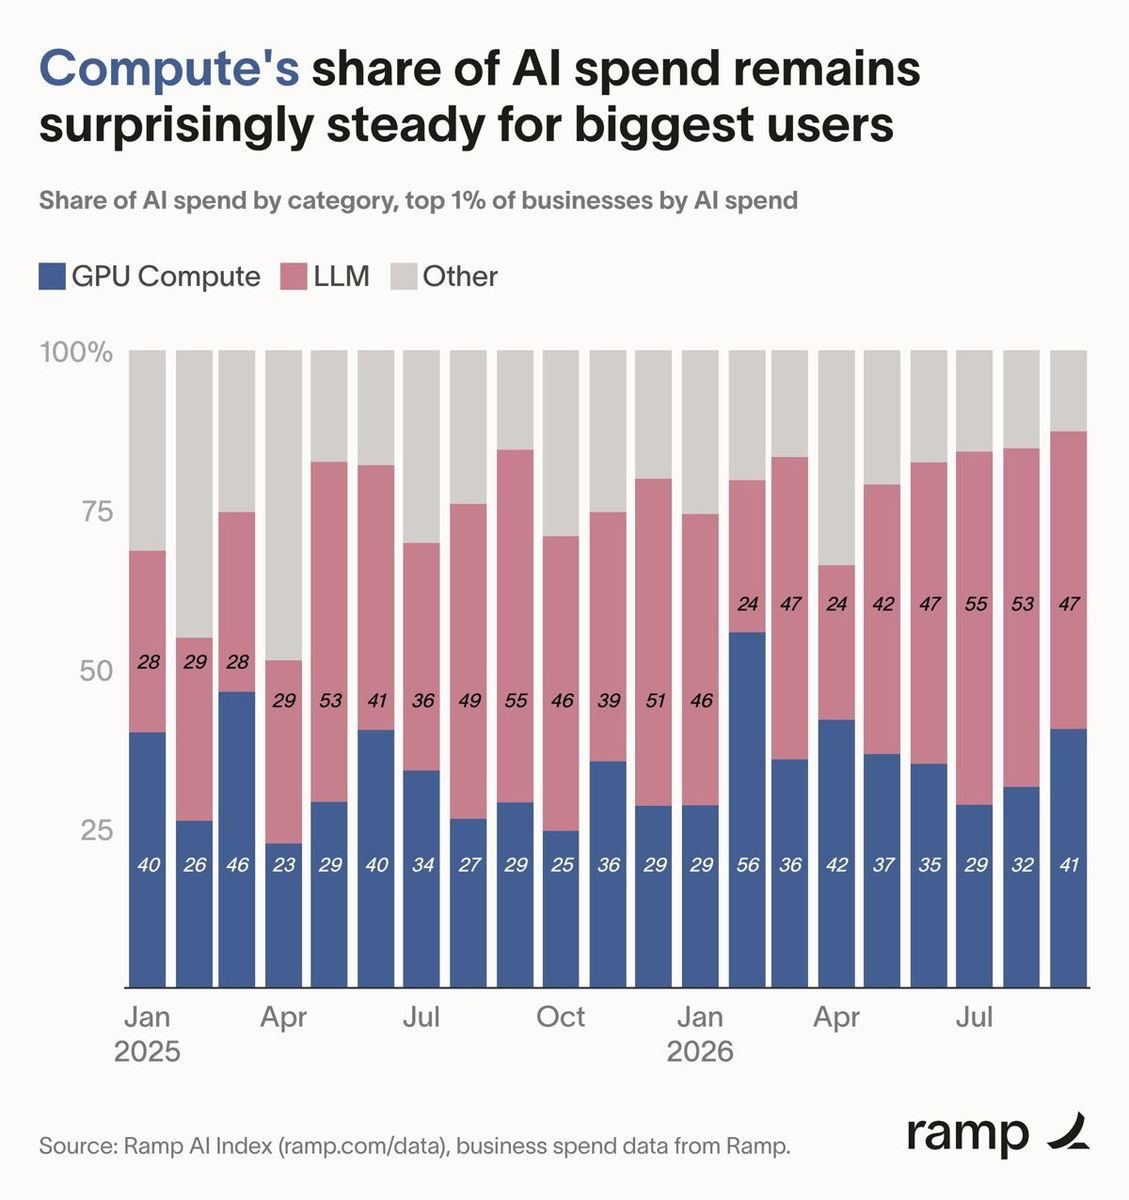
企业支出管理公司 Ramp 经济学家 Kharazian 公布头部企业 AI 支出结构,算力占比约 41%

Ara Kharazian(Ramp 经济学家)称,AI 支出最高的 1% 企业,超过三分之一的 AI 支出已用于算力。 @arakharazian X 帖图表标题称这一占比“出奇稳定”:2025 年 1 月以来 GPU 算力占比在 23% 至 56% 之间波动,最新约 41%,大模型约 47%。 @arakharazian X 帖该图未见于 Ramp AI 指数官网页(10-25 已查);官网 10 月指数显示,AI 支出前 1% 企业的月人均 AI 支出中位数为 9567.53 美元,占 OpenAI 与 Anthropic 企业支出的 80%。 Ramp AI 指数(10 月)

配图:企业支出管理公司 Ramp 经济学家 Kharazian 公布头部企业 AI 支出结构,算力占比约 41%
Ramp AI 指数:AI 支出前 1% 企业各类支出占比,GPU 算力占比最新约 41%,大模型约 47% 原图来源:Ara Kharazian X 帖 @arakharazian X 帖
21

Claude Code 团队的 Thariq 与桌面版创建者 Anthony Morris 相继离开 Anthropic

Thariq(Claude Code 团队)10-24 12:04 称,在 Claude Code 工作一年多后已离开 Anthropic;Claude Code 桌面版创建者 Anthony Morris 10-24 20:33 称,10-23 是他在 Anthropic 的最后一天。 @trq212 X 帖 @amorriscode X 帖

算力金融与资本开支5 事件
22

英伟达季报披露为 OpenAI 俄亥俄数据中心租约担保最高 1050 亿美元,所投云厂商本月股价至少跌 30%

10-22 已报英伟达投资与承诺超过 1700 亿美元,The Information 10-24 23:30 再次推送该报道。 @theinformation X 帖今日新增:CNBC 报道英伟达作为 AI 融资方面临首次大考。 CNBC 报道据英伟达 8 月季报(截至 7 月 26 日),英伟达与 AI 云厂商签有 360 亿美元云服务采购承诺(通常 6 年);为 SB Energy 为 OpenAI 在俄亥俄州建设的约 4.25 吉瓦 IT 负载数据中心提供最高 1050 亿美元租约担保(分 9 期,首期在 2029 财年,租期 20 年,另有约 3.8 吉瓦扩建选择权),连同为 AI 云厂商的土地、电力与厂房提供的 35 亿美元,最高担保敞口合计 1085 亿美元;8 月英伟达与多家大型资本方签署谅解备忘录,拟动员超过 5000 亿美元第三方资本。 英伟达 8 月季报(10-Q)

【仅见媒体报道】CNBC 另称,英伟达向金融机构承诺 GPU 融资最高 1250 亿美元的残值担保,另有 200 亿美元租赁(这两个数字季报中未查到);其投资组合中的 CoreWeave、Nebius、IREN 本月股价均至少跌 30%,CoreWeave 信用违约互换利差超过 11%,英伟达股价 10 月跌 7.6%。 CNBC 报道

【仅见媒体报道】The Information 10-25 01:00 称,CoreWeave 的前景已成为判断整个 AI 建设能否获得融资的依据,投资者已开始按“不能”的预期交易。 @theinformation X 帖同日,AI 视频公司 Higgsfield 首席执行官 Alex Mashrabov 称黄仁勋和英伟达投资了该公司,金额未披露。 @alexmashrabov X 帖

23

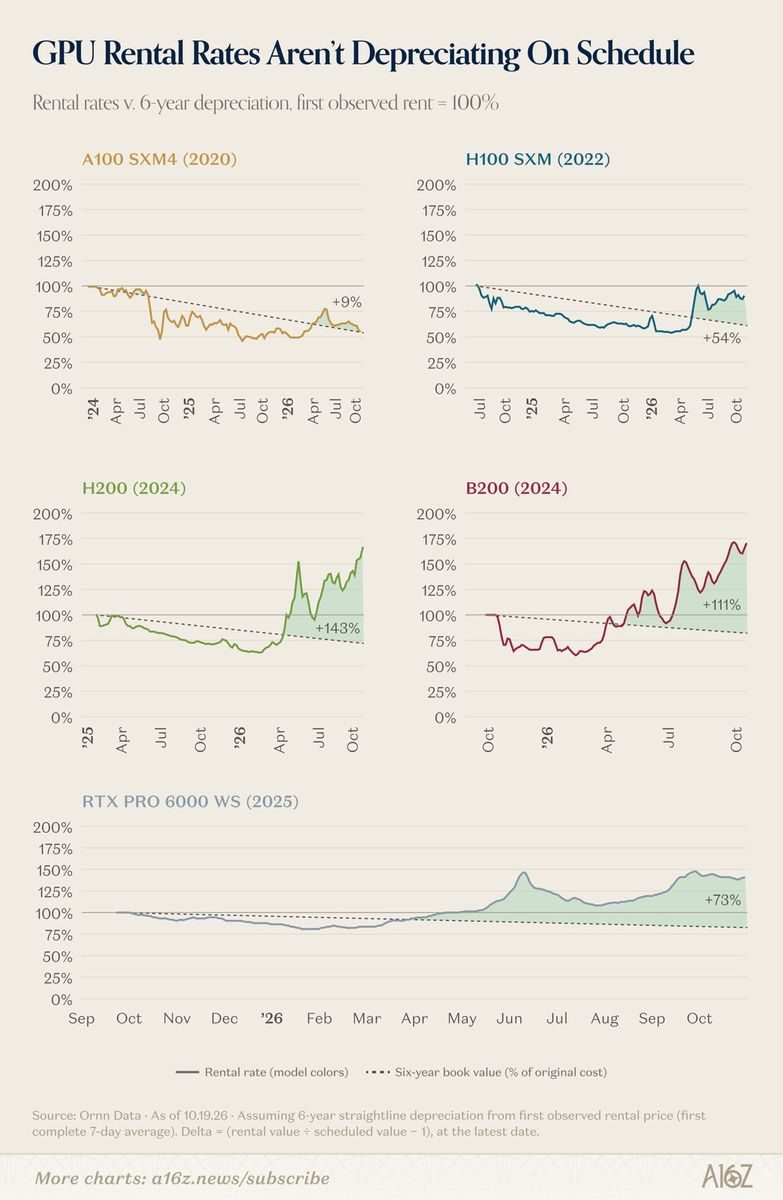
风投机构 a16z 称 GPU 租金普遍高于 6 年折旧曲线,H200 高出 143%

10-24 已报 GPU 租金年内上涨。今日新增:a16z 称,GPU 租金高于标准 6 年折旧曲线:H200 高 143%、B200 高 111%、RTX PRO 6000 高 73%、H100 高 54%、A100 高 9%;差距主要在 4 月 token 需求上升后拉开。 @a16z X 帖 a16z 文章

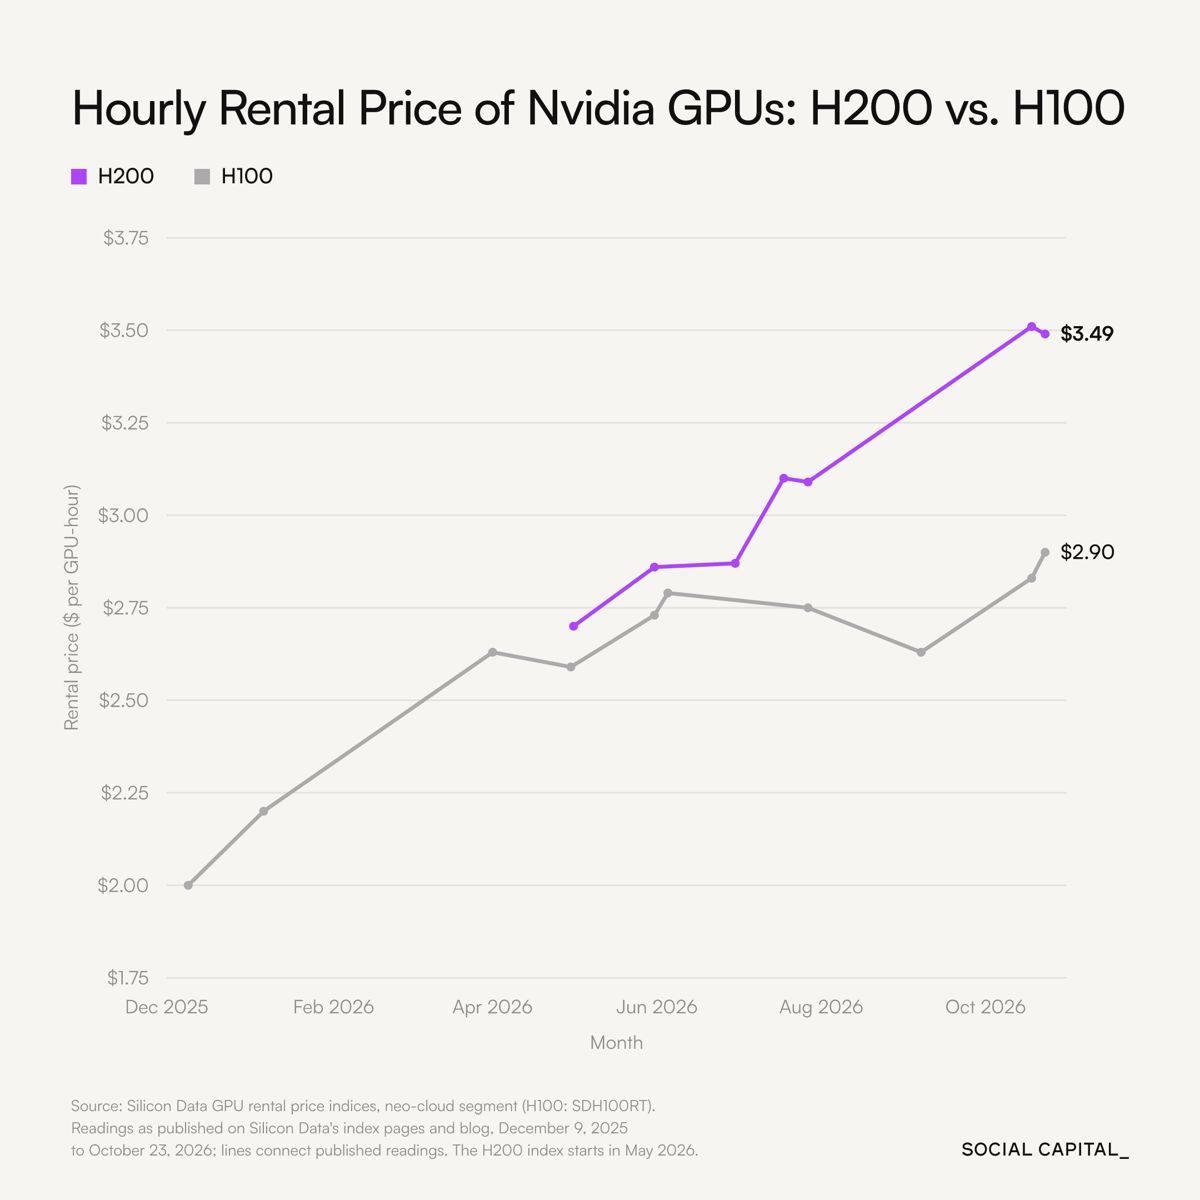
Social Capital(Chamath Palihapitiya 创办的投资机构)称,H100 租金比 12 月高 45%,该芯片 2022 年上市,此后已推出两代新品。 @socialcapital X 帖

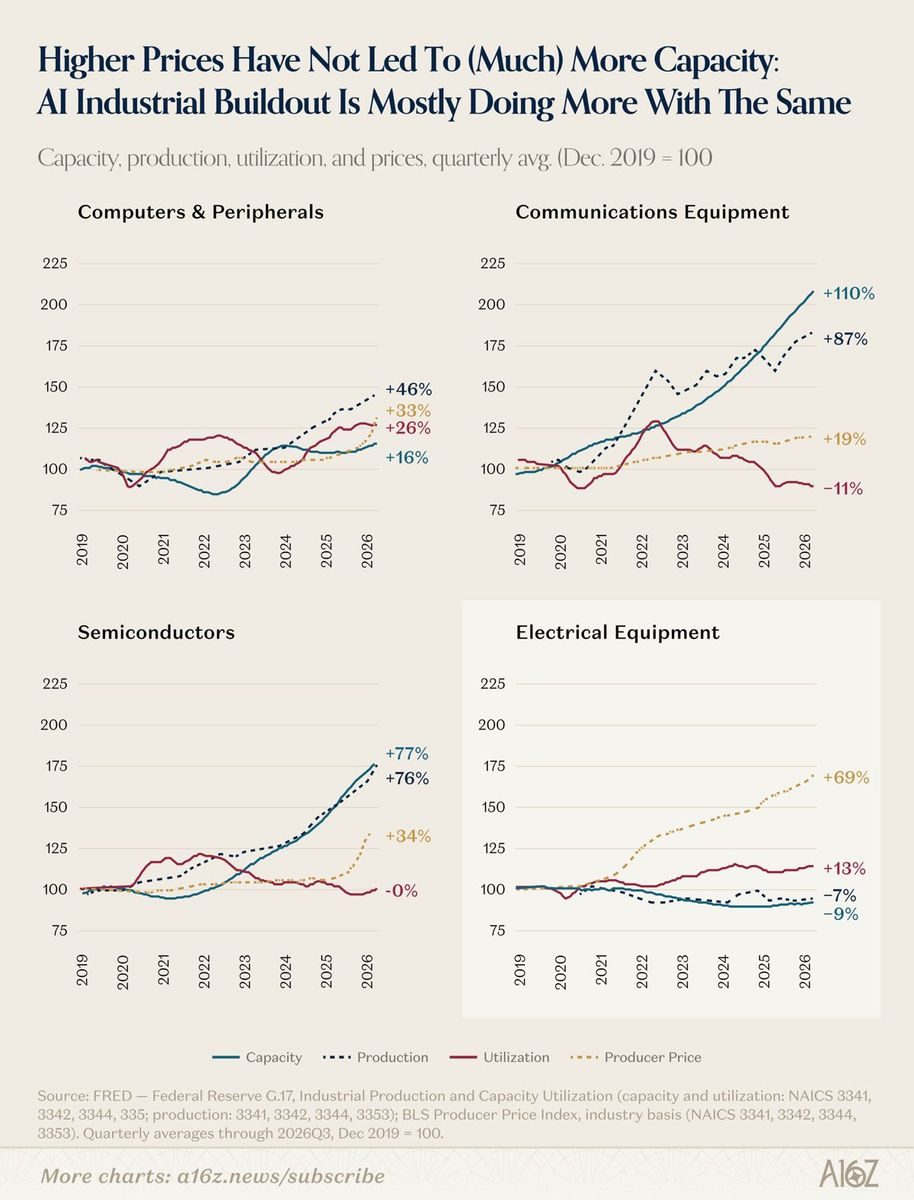
a16z 另称,电力是 AI 基础设施建设的主要制约因素之一,2019 年以来美国电气设备产能下降 9%,价格上涨 69%,涨幅在四类中最大;同期通信设备产能增 110%、半导体增 77%、计算机增 16%。 @a16z X 帖

配图:风投机构 a16z 称 GPU 租金普遍高于 6 年折旧曲线,H200 高出 143%配图:风投机构 a16z 称 GPU 租金普遍高于 6 年折旧曲线,H200 高出 143%配图:风投机构 a16z 称 GPU 租金普遍高于 6 年折旧曲线,H200 高出 143%
GPU 租金与 6 年直线折旧对比:A100 +9%、H100 +54%、H200 +143%、B200 +111%、RTX PRO 6000 +73%,数据来自 Ornn Data,截至 10-19 原图来源:a16z X 帖 @a16z X 帖
美国四类制造业产能、产量、利用率和价格(2019 年 12 月 = 100,至 2026 年三季度),数据来自 FRED G.17 与 BLS 原图来源:a16z X 帖 @a16z X 帖
新兴云厂商 GPU 租金指数:H100 由 2025 年 12 月 2.00 美元/时升至 2.90 美元/时,H200 为 3.49 美元/时,数据截至 10-23 原图来源:Social Capital X 帖 @socialcapital X 帖
24

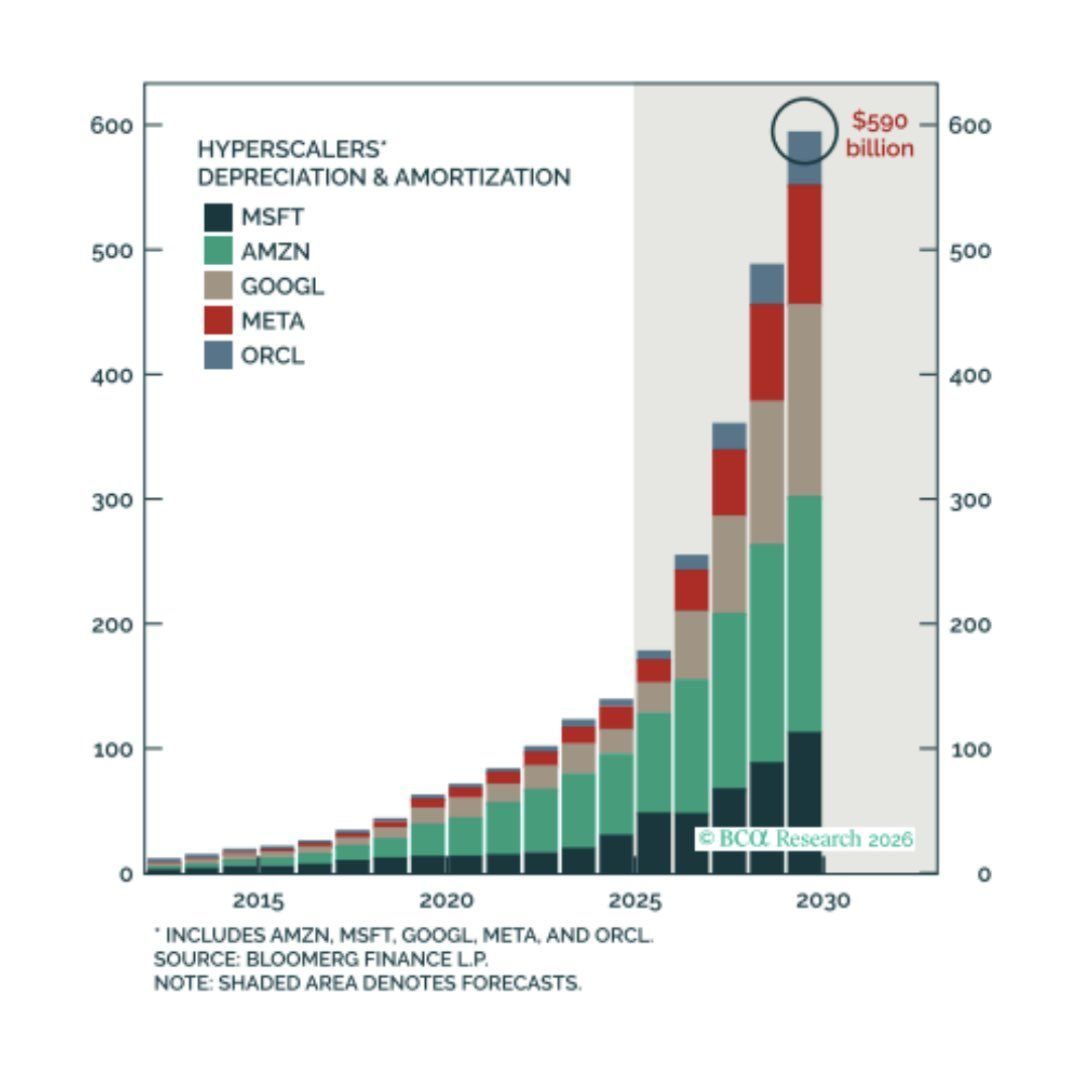
投资研究机构 BCA Research 首席经济学家 Peter Berezin:五大云厂商折旧摊销 2029 年将达 5900 亿美元

Peter Berezin(BCA Research 首席经济学家)称,微软、亚马逊、谷歌、Meta、甲骨文的折旧摊销费用 2029 年将达 5900 亿美元,可能超过它们 2026 年的合计营业利润。 @PeterBerezinBCA X 帖

配图:投资研究机构 BCA Research 首席经济学家 Peter Berezin:五大云厂商折旧摊销 2029 年将达 5900 亿美元
五大云厂商折旧摊销(阴影为预测):2029 年合计 5900 亿美元,数据来自彭博 原图来源:Peter Berezin X 帖(BCA Research) @PeterBerezinBCA X 帖
25

英特尔、AMD、英伟达被传预付订金锁定台湾芯片载板产能,合计逾新台币千亿元

订金金额【仅见媒体报道】:经济日报 10-24 02:28 报道,业界传出三家已付出总额逾新台币千亿元订金,预定高阶 IC 载板厂长期产能;法人与业界估算三家对载板的投资合计约 50 亿美元,其中英特尔长期预购约 30 亿美元,AMD、英伟达各约 10 亿美元(均为估算)。 经济日报报道Jukan(半导体资讯账号)10-24 07:07 转引了这一报道。 @jukan05 X 帖

背景:报道引述英特尔首席执行官陈立武此前称,AI 带动先进封装和芯片需求,上游 IC 载板和材料吃紧,有客户已提前向英特尔支付预付款锁定产能;欣兴、景硕、南电等载板厂今年宣布的投资建厂规模累计达新台币 1612 亿元,创新高。 经济日报报道

官方背景:英伟达 10-21 新闻稿称,已与欣兴签订产能预留协议,支持其在台湾扩充 KF 载板产能(2027 年第二季度起供货,2028 年年中满产),并向 IBIDEN 预付数十亿美元;三年内载板产能扩大 2.5 倍。新闻稿未披露金额,也未提英特尔、AMD。 英伟达新闻稿

26

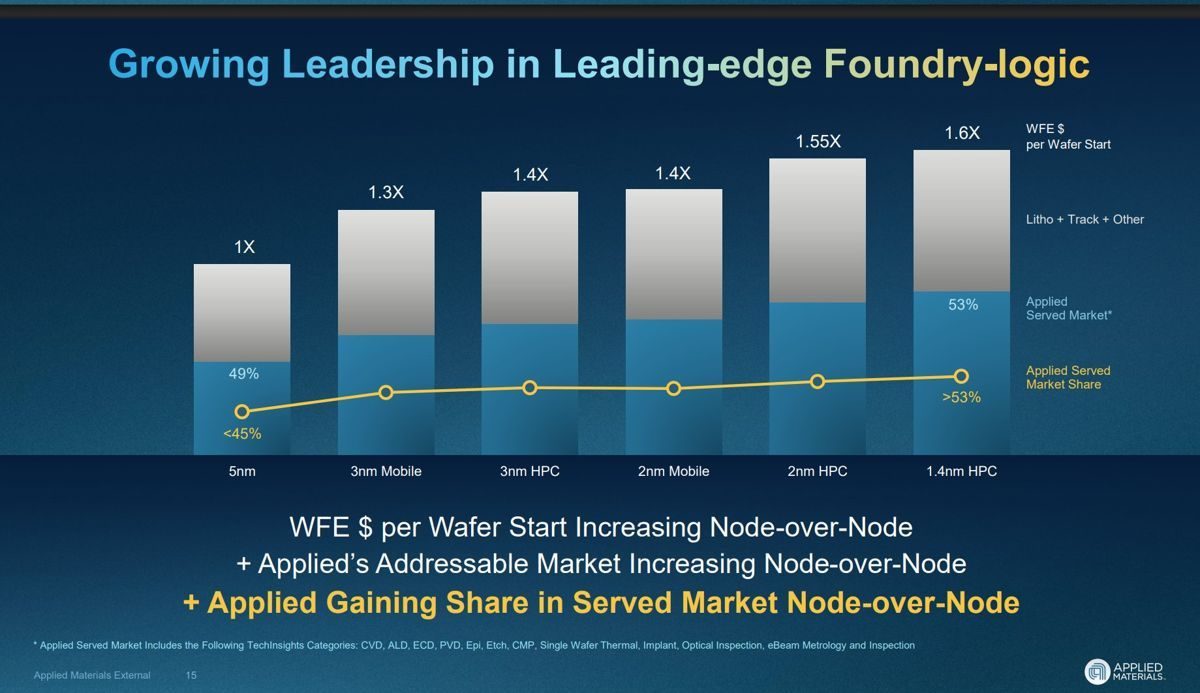
半导体分析师 Kundojjala 引应用材料数据,2nm 高性能计算晶圆设备投入比手机芯片高 11%

Sravan Kundojjala(SemiAnalysis 分析师)转引应用材料 10-13 投资者早餐会图表称,从 3nm 到 1.4nm,单片晶圆的设备投入增长 16% 以上,应用材料可服务市场增长 25%,其收入增长 33%,可服务市场份额由不到 45% 升至 53% 以上。 @SKundojjala X 帖 应用材料投资者早餐会

他补充,2nm 高性能计算晶圆的设备投入比手机芯片高 11%(1.55 倍对 1.4 倍),AI 与高性能计算需求提高应用材料的单片晶圆收入。 @SKundojjala X 帖

配图:半导体分析师 Kundojjala 引应用材料数据,2nm 高性能计算晶圆设备投入比手机芯片高 11%
应用材料图表:以 5nm 为 1X,3nm 手机 1.3X、3nm 高性能计算 1.4X、2nm 手机 1.4X、2nm 高性能计算 1.55X、1.4nm 高性能计算 1.6X 原图来源:应用材料 10-13 投资者早餐会材料,经 Sravan Kundojjala X 帖转引 @SKundojjala X 帖

政策与治理动态

Policy & Governance4 事件
27

得州总检察长 Paxton 起诉 OpenAI,要求新模型发布前须经第三方审批

得州总检察长 Ken Paxton 10-23(美国时间)宣布在科林县地区法院起诉 OpenAI 及其关联实体和 Sam Altman,指控违反《欺诈性贸易行为—消费者保护法》(DTPA)和保护未成年人的 SCOPE 法案。 得州总检察长新闻稿

起诉书称,OpenAI 2024 年初得知谷歌将于当年春季发布更新模型后,把 GPT-4o 的发布提前到谷歌发布前一天;本需数月的安全测试只做了一周评估,安全人员要求延长测试时间,被 Altman 本人否决。 得州起诉书

起诉书请求临时和永久禁令,包括禁止向得州未成年人提供 ChatGPT,以及在经法院批准的独立第三方评估方审查其安全护栏并批准发布之前,向得州用户发布任何新 AI 模型;另请求按每项违法行为判处 1 万美元民事罚款,金钱救济超过 100 万美元。 得州起诉书

28

英国财政部公布数亿英镑 AI 投资计划,含 1 亿英镑 AI 生物安全实验室

英国财政部 10-24 13:00 发布公告,称财政大臣 John Healey 将于下周公布一揽子 AI 投资,并把 AI 纳入其预算案;当天已宣布的投资达数亿英镑。 英国政府公告

安全方面:1.65 亿英镑用于国家 AI 生物安全计划,其中 1 亿英镑建 AI 生物安全实验室(AIBL),用 AI 检测和监测生物威胁,6500 万英镑用于加强生物监测和为重点病原体研发医学对策;AI 安全研究所追加 1.2 亿英镑;6000 万英镑建设使用智能体 AI 的国家网络防护系统,含 2500 万英镑挑战基金,并研究设立监管沙盒;另设 7000 万英镑的国家暴露面与实时漏洞中心(NERV),用 AI 工具识别关键基础设施和经济领域的网络漏洞。 英国政府公告

自主能力方面:主权 AI 基金追加 6000 万英镑并扩展到物理与工业 AI(机器人、自主系统、先进制造等),主权 AI 研发采购计划追加 6000 万英镑,另以 1800 万英镑设立先进芯片设计学院。 英国政府公告

就业与地方方面:每年 1000 万英镑研究 AI 将如何重塑就业和产业;AI 经济研究所未来三年追加 2300 万英镑;1500 万英镑设 AI 挑战奖,首个奖项面向用 AI 解决健康问题的企业;3000 万英镑启动与市长战略机构的地方 AI 合作。 英国政府公告
英国内阁办公室 10-24 07:01 介绍,AIBL 将作为独立非营利机构运作,获政府 1 亿英镑资金及 OpenAI、Anthropic 合计最高 2 亿英镑的承诺:OpenAI 提供 1 亿英镑算力与模型额度,并通过 Rosalind Biodefense 计划提供其最强相关模型的可信访问;Anthropic 提供最高 1 亿英镑模型额度、可信模型访问和专门技术支持;谷歌 DeepMind 与 Basecamp Research 为研究合作方,DeepMind 将寻求提供前沿 Gemini 及专用科学模型的可信访问。 英国政府公告

29

美国国家标准与技术研究院等三部门 10-16 发布超级智能事件应对实践,列 10 项自愿措施

NIST 10-24 23:15 发帖再次推介这份 10-16 发布的文件:NIST 下属 CAISSI、NSA 下属 SISC 与 CISA 联合发布《超级智能训练与评估中的事件准备与响应关键实践》(1.0 版)。 @NIST X 帖

文件面向训练或评估在长周期任务中、人类监督有限的高能力超级智能体的机构,提出准备、检测、响应、恢复、报告五个阶段共 10 项自愿实践,并定义“超级智能失控事件”(未经指示的行动)和“险兆事件”(未酿成失控、但有可预见风险的事件)。 NIST 文件

具体条目包括:使用一次性基础设施、限制智能体之间的通信渠道、网络访问实行严格白名单;训练前做结构化风险评估并由高层签批;用多个模型家族做监控;按严重程度暂停同类智能体;恢复时不得以降低可监控性的方式针对不良思维链训练;自愿向 NIST CAISSI 和 NSA SISC 通报。致谢名单包括 Anthropic、CrowdStrike、Darktrace、Dreadnode、Gray Swan、微软、Palo Alto Networks 等。 NIST 文件

30

商务部坚决反对美国对外投资限制拟议规则,称其歧视性扩大对华限制

10-24 已报美国财政部 10-22(美国时间)发布对外投资安全计划拟议规则,把“超级智能系统”开发列为禁止类投资。今日新增:商务部新闻发言人 10-24 19:17 答记者问称,该拟议规则“歧视性扩大对华投资限制范围,加大限制力度,是典型的泛化国家安全做法”,违背两国元首达成的重要共识,干扰中美两国企业正常经贸合作;中方“表示严重关切、坚决反对,将密切关注事态后续发展,保留采取相应措施的权利”,并敦促美方“停止泛化国家安全概念,停止将经贸问题政治化、武器化”。 商务部答记者问

美国联邦公报显示,该拟议规则(文件号 2026-21786)10-23 20:45 进入公开查阅,定于 10-26 正式刊登,书面意见须在 12-07 前送达。 联邦公报

统计

Pipeline Stats
30事件数
AI战略研究所 编制 · 仅供内部参考