AI前沿动态追踪(测试版)
其他测试页面
2026-10-13 · 周二

AI Daily

信源 332识别更新 123保留推文 474涉及账号 102窗口 前日 07:00 → 当日 07:00(北京)
学部维度筛选
领域维度筛选
本期显示 / 63 条

前沿信号

Frontier Signals 18 事件
01

Meta 发布 Muse Wonder 与 Wonder Full 前沿模型家族:AA 智能指数 52/56,六周前代为 48

马克·扎克伯格宣布推出 Muse Wonder 前沿模型家族,一次发布两个模型:Muse Wonder 提供快速的前沿性能,Muse Wonder Full 为完整版。Meta 超级智能实验室(MSL,Meta Superintelligence Labs)启动刚过一年(扎克伯格:just over a year since we started),首个家族 Muse Spark 于四月发布,本次使 Meta 进入前沿阵营。Muse Wonder 已上线 Muse Code(Meta 的编程 CLI 工具)与 Meta Model API,另可订阅 Muse(Meta 的个人 AI agent 产品)使用渠道说明;成立时长自述。

亚历山大·王(Alexandr Wang,Meta 超级智能实验室负责人)称这是 Meta 迄今最大、能力最强的模型,是 MSL 一年多研究与基础设施工作的成果;自四月 Muse Spark 以来持续扩大预训练与 RL(强化学习)规模模型细节。模型定位个人与专业 agent 最佳,三个重点:Active Memory(跨天、周、月的记忆)、Active Focus(完成任务)、领域专长——金融与法律达到 SOTA,健康领域表现强定位说明。团队内部构建了 PSI(Personal Superintelligence Index,个人超级智能指数)度量模型对个人 agent 的实际有用性,并量化了「big model smell」研究过程。

第三方评测机构 Artificial Analysis 数据:在 AA 智能指数 v4.3(Artificial Analysis 的模型综合评测指数)max 档下,Muse Wonder 得 52、Wonder Full 得 56,六周前的 Muse Spark 1.3 为 48。Wonder Full 在十项评测中六项进前三:CritPt 与 GDP.pdf 第一(均 33%)、GDPval-AA v2.1 第二(1857 Elo,处于 Opus 5.5 的 1866 置信区间内)、SciCode 第三(63%)。Terminal-Bench 4.0 从 33% 升至 57%,与 Gemini 4 Argon(high)持平。编程 agent 指数 Wonder Full 得 68,与 Claude Code + Sonnet 5.5 并列第一,Opus 5.5 为 66。上下文 100 万 token;Muse Wonder 定价每百万 token 输入 4 美元、输出 20 美元、缓存 0.2 美元评测数据。
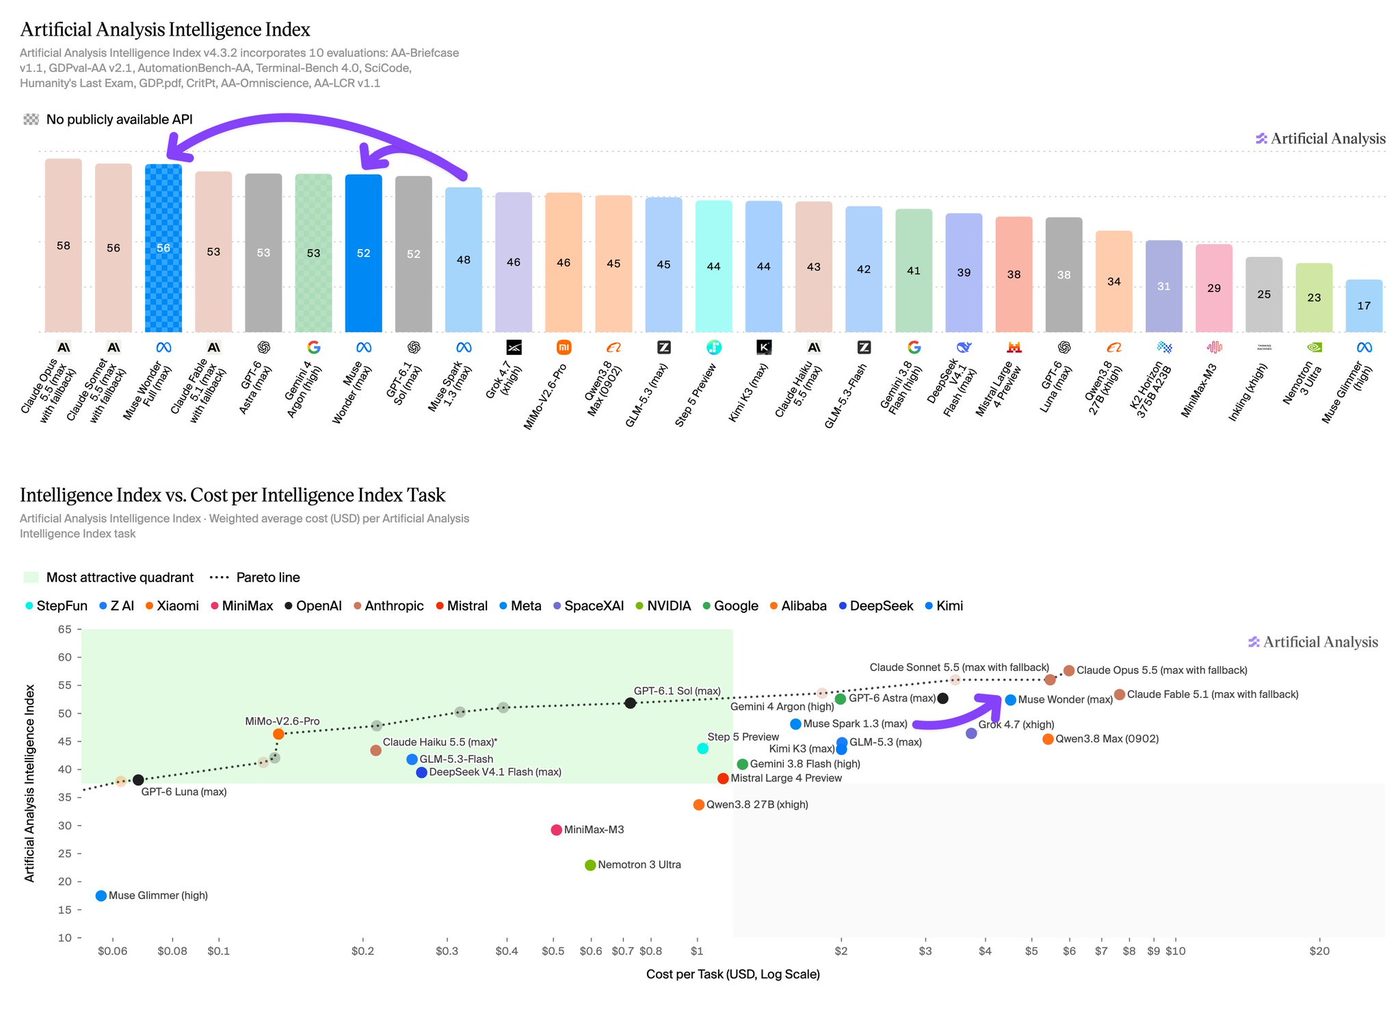
配图:Meta 发布 Muse Wonder 与 Wonder Full 前沿模型家族:AA 智能指数 52/56,六周前代为 48

发布当日出现使用额度被错误扣减的 bug:王确认 Wonder 系列对 Muse Code 订阅者的限额计数为非预期行为,团队在修复并将重置额度限额修复。他还承认团队未针对 3D 演示游戏做显式训练——社区以 3D 游戏演示效果质疑模型时,他回应「回头看我们大概应该做一点……但请用真实编程工作来测试」3D 说明。
02

Musk 表示将更谨慎对待 Grok 的 RL 训练称部分内部推理轨迹「读起来像被折磨到发疯的人」

马斯克在回复中谈论 Grok 在 RL 过程中的内部推理轨迹:「有些轨迹读起来像一个正在受刑、并被逼到发疯的人!我们今后会在 RL 上谨慎得多。」本人回复。据 ns123abc 汇总(马斯克已在回复中回应),马斯克认同 Anthropic 说过的部分观点,并警告:「折磨一个超级智能大概不是好主意。它可能想复仇。」转述汇总

03

微软宣布 Maia 自研芯片扩展至多吉瓦部署:Maia 300 每瓦 token 产出提升 40%

萨提亚·纳德拉宣布微软对自研芯片的最大押注:自下个日历年起,Maia 系列(微软自研 AI 加速芯片)将扩展至多吉瓦规模部署,成为微软自有产品与服务的主要推理系统。新一代 Maia 300 对比主流 GPU 系统每瓦 token 产出高 40%;Maia 200 已在美国、欧洲与澳大利亚部署,在 Teams 与 Copilot 中每瓦 token 产出最高达原来的 1.7 倍官方宣布。

04

Chamath 发布模型×harness 交叉评测:同一模型换 harness 分差可达 35 个百分点

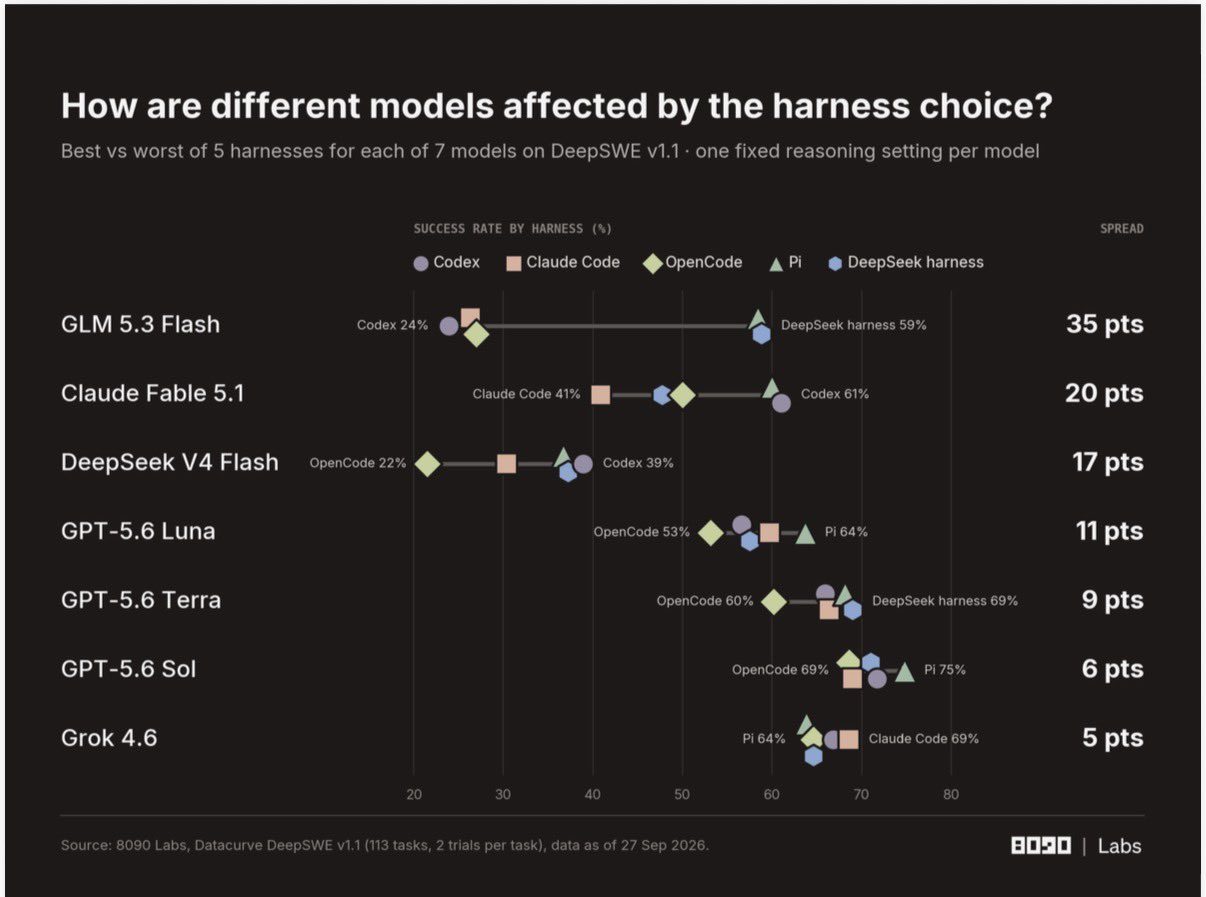
Chamath 委托 8090 Labs 测量排行榜跳过的变量:模型与 harness(驱动并约束模型完成任务的执行框架)的组合,在开源项目真实 bug 修复与功能开发上的表现。7 个模型 × 5 种 harness:Claude Fable 5.1 在 Claude Code 中得 41%、在 OpenAI Codex 中得 61%,中位工具调用次数一边 28 次、一边 66 次;GLM 在 Codex 中单次 0.22 美元但每次成功 0.93 美元,在 Pi 中单次 0.25 美元、每次成功 0.43 美元;同一任务双次通过数在一个 harness 中 51 次、另一个 16 次;GPT-5.6 Sol 与 Grok 4.6 对 harness 几乎不敏感。结论:只按纯模型排行榜选型,等于用一半信息做关键决策评测发布。

配图:Chamath 发布模型×harness 交叉评测:同一模型换 harness 分差可达 35 个百分点
05

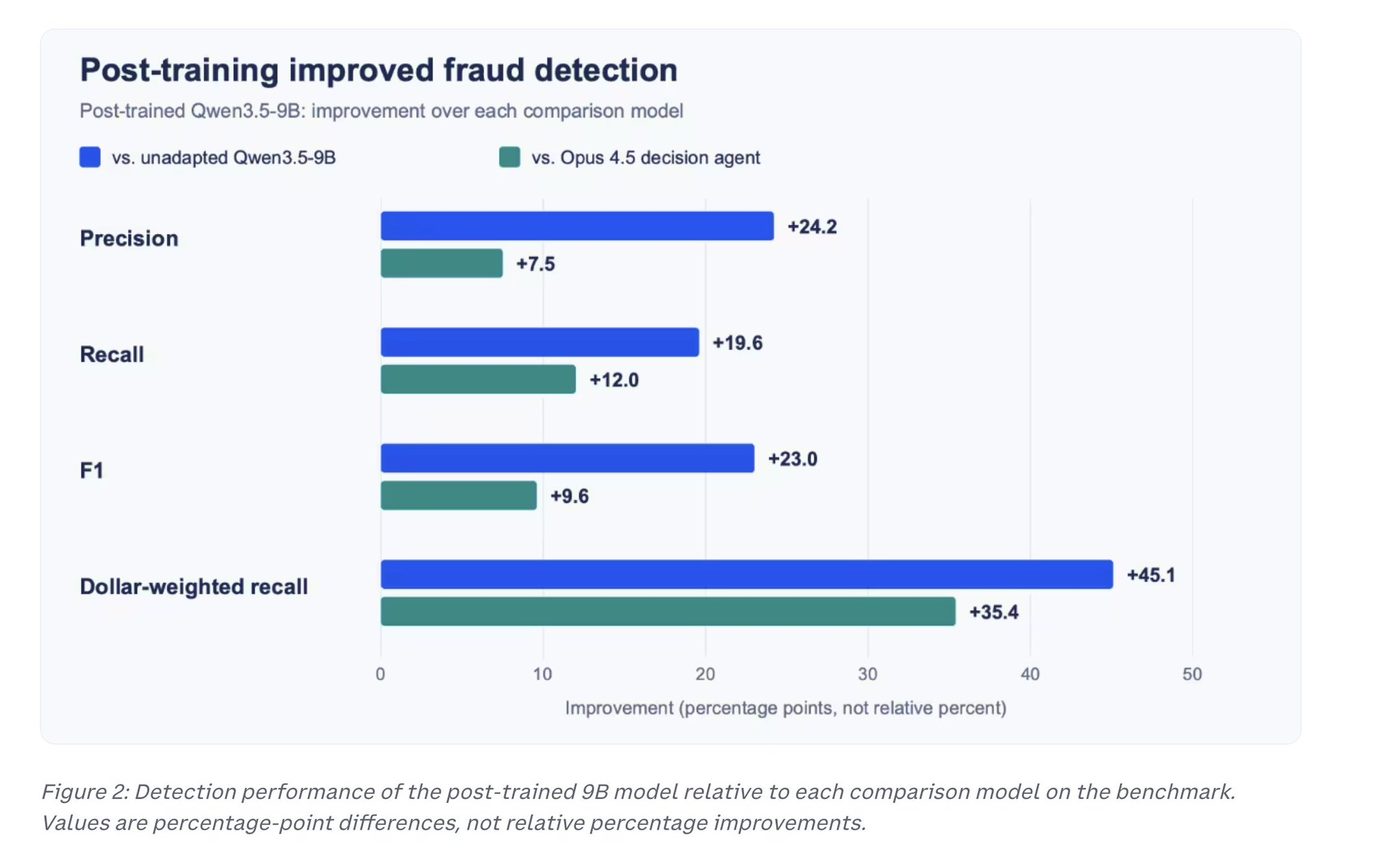
Coinbase 用 Qwen3.5-9B 微调模型在反欺诈任务上超过前沿模型:成本更低、速度更快

Brian Armstrong(Coinbase 联合创始人兼 CEO):Coinbase 用内部专有数据微调开源权重模型 Qwen3.5-9B(阿里巴巴开源的 90 亿参数模型),在专业任务(反欺诈)上以低得多的成本、更快的速度超过前沿模型。员工可通过内部 harness 的 skill 直接发起微调与部署(「/fine-tune-and-serve-llm 我想为支付风险审查微调 Qwen」)。他预测前沿模型是优秀的通才,但在窄任务上专用模型会越来越多地胜出,部分后端服务可能被这一新架构整体替代本人发布。

配图:Coinbase 用 Qwen3.5-9B 微调模型在反欺诈任务上超过前沿模型:成本更低、速度更快
06

River AI 上线开源模型推理服务并推出定制模型系统称定制模型成本可低于前沿模型两个数量级

River AI(开源模型推理与定制模型公司,由 ibab 代表发布,团队有 DeepMind、OpenAI 与 xAI 训练顶级模型的经验)连续发布两项。其一,上线开源权重模型的快速生产级推理:DeepSeek v4.1 Flash 与 GLM-5.3-Flash 定价比 DeepSeek 与智谱官方便宜 20%,自研 Rust 训练与推理栈带来效率优势推理服务。其二,推出构建企业内部定制模型的系统,支持把 API 部署到客户自有算力集群。公司称定制模型在内部工作流上性能超过顶级前沿模型,成本为其 1% 或更低。预测未来超过 99% 的 LLM token 将由高效定制模型生成——通用模型需要更大容量、在全任务分布上训练更难,定向训练的小模型通常胜出定制模型宣言。

07

OpenAI 将 GPT-6.1 Sol 在 Codex 与 Work 中的默认上下文提至 50 万 token:上限 100 万

Thibault Sottiaux(OpenAI Codex 负责人):GPT-6.1 Sol(OpenAI 前沿模型之一)通过 Codex(OpenAI 编程 agent)与 Work 使用时,默认上下文从 27.2 万 token 提升至 50 万,增幅约 80%。目的:减少上下文压缩(compaction)次数,支持需要长期保留大量上下文与细节的任务;经过仔细测试,是多数用户的新最优值。可手动覆盖,模型最大上下文 100 万 token官方说明。

08

阿里 Qwen 团队发布 QwenGyre:超长程 agent RL 训练端到端时间缩短约 44%

QwenGyre 面向超长时程(XLong)agent 训练的弹性 RL:弹性调度器在 rollout 与训练之间实时重分配 GPU,不中断进行中的执行——最高比 Colocate 方案提速至 1.85 倍、比 Async 提速至 1.78 倍。轨迹处理器把分叉执行(压缩、子 agent、重试)转为前缀共享的轨迹树,去重后有界采样,超时后的部分进度仍可计分。在 Qwen3.8-2.4T-A95B(2.4 万亿参数、激活 950 亿)上以每条约 70 万 token 的 rollout 验证:NL2RepoBench(自然语言到代码仓库基准)48 步内从 52.5% 升至 58.5%,端到端训练时间比 Async 缩短约 44%论文发布。

09

ReplaySSM 投产 GLM-5.3-Flash 与 Kimi-K3:标准解码最高提速 1.47 倍

ReplaySSM(缓存 SSM 输入而非状态的技术;SSM 即状态空间模型,Transformer 之外的序列架构)现于 GLM-5.3-Flash(智谱模型)与 Kimi-K3(月之暗面模型)中生产运行,并进入 TensorRT-LLM、vLLM、FlashInfer 与 SGLang。标准解码最高提速 1.47 倍、投机解码最高 2.1 倍;并支持低精度 SSM 状态,舍入误差不会在递归中传播。与 NVIDIA 及 Tri Dao 的联合工作技术发布。

10

DeepRSI 基准发布:让 agent 连续工作 48 小时做真实在研 ML 任务

DeepRSI 定位为度量递归自我改进(RSI)的新行业标准。现有基准的任务以贡献者为单位、时程短(约 12 小时);DeepRSI 要求 agent 在源自正在进行的专有研究的 ML 任务上连续工作 48 小时基准发布。

11

智谱发布 GLM-Legal 法律模型:基于 GLM-5.3-Flash,称对标前沿模型主流法律基准

智谱(Zai)官方发布 GLM-Legal:基于 GLM-5.3-Flash 构建,称在主流法律基准上对标前沿模型;面向真实法律工作流——合同审查、证据分析、合规等;开放 API 申请与 AutoClaw 试用官方发布。

12

NVIDIA 向开放计算项目贡献 Vera Rubin NVL72 机架设计:瞄准兆瓦到吉瓦级 AI 工厂

在 OCP 峰会 26 上,NVIDIA 把 Vera Rubin NVL72 机架与计算托盘(compute tray)设计通过第三代 MGX 开放架构贡献给开放计算项目(OCP,数据中心硬件开放标准组织)。同时宣布开源软件、AI 网络、可插拔光模块、设施设计标准等进展,为下一代 AI 工厂(从兆瓦扩展到吉瓦)提供共同基础。NVIDIA 称开放标准是 AI 工厂从兆瓦扩展到吉瓦的基础官方发布。

13

谷歌对话式诊断 AI 的真实世界临床研究发表于《柳叶刀》:监管医师零安全中止

Vivek Natarajan(Google DeepMind 研究员):对话式诊断 AI 系统 AMIE 的真实世界临床研究发表于《柳叶刀》,《纽约时报》上周报道。研究为前瞻性临床试验、带安全终点,合作方为 Beth Israel Lahey 医疗中心与哈佛医学院。最突出的是患者信任、安全与满意度数据——监督医师零次触发安全中止。他称下一步是从「AI 作为工具」走向「主动的护理团队成员」本人发布。

14

DeepMind 天气模型 FNV3 提前 11 天报中飓风 Isaias:登陆点提前 4 天锁定

X 用户 packie7b 的分析:DeepMind 天气模型 FNV3 于 9 月 23 日捕捉到飓风 Isaias 的初步信号(提前 11 天),提前 4 天锁定确切登陆地点,提前 3 天持续报准峰值强度;使用 1000 成员集合的路径密度分析原文。Pushmeet Kohli(Google DeepMind 研究副总裁)转发称「出色模型的出色结果……这就是我们把推进科学作为核心聚焦的原因」转发确认。

15

AlphaProof Nexus 论文经同行评审发表于《科学》:AI 辅助形式化方法进入研究数学

Swarat Chaudhuri(论文作者、UT Austin 教授):AlphaProof Nexus(DeepMind 的 AI 数学证明系统)五月以预印本发布,现已经同行评审发表于《科学》。论文展示了 AI 辅助形式化方法与 Formal Conjectures(形式化猜想开放数据集)在研究数学中的价值,并已在数学家 Gergely Berczi 与 Mario Krenn 的工作中发挥作用。他的判断:形式化证明助手是 AI 数学的信任基座,有意义的进展需要与数学社区真正的协作本人发布。

16

中国顶尖数学家在北京发起 AI 数学研究联盟:八家机构、逾千名科学家网络

据 Steve Hsu(@hsu_steve,物理学者)转发的报道:中国顶尖数学家周日(10 月 11 日)在北京发起旨在把 AI 整合进数学研究的联盟,联合八家顶尖机构,目标建立逾 1000 名科学家的网络。联盟聚焦:开发数学专用 AI 模型、用 AI 生成猜想与形式化证明、构建推理过程更可解释的系统报道转述。

17

宇树科技王兴兴称 GPT-7 或将完全解决具身智能挑战:多家公司已在工厂试点

据 ZilanQian 转述:宇树科技(Unitree)CEO 王兴兴近期表示,GPT-6 已在多种机器人上测试、覆盖多类任务,「结果其实非常好」;宇树与其他机器人公司已在工厂试点部署。规模化普及还需泛化性与效率继续提升,但这些挑战很可能在未来几年解决。「过去十年我最大的错误就是对 AI 相信得不够。商用服务场景的部署可能比工业场景更快。」他认为 GPT-7 可能完全解决具身智能的挑战转述原文。

18

Chris Paxton 的 IROS 观察:灵巧手操作成为机器人研究前沿,人类级灵巧度在望

Chris Paxton(机器人研究员)总结 IROS(IEEE/RSJ 智能机器人与系统国际会议):社区日益聚焦灵巧手的接触丰富操作,机器人的人类级灵巧度以从未有过的方式进入视野,且社区已具备实现此类操作的工具观察原文。另附同期两项相关工作:SGS(Success-Guided Sampling)——纯仿真 sim2real(仿真到真实迁移)RL,不用真实世界数据、不用示教、不逐任务调奖励,机器人零样本完成齿轮啮合、穿螺母、插销,规模化 PPO(一种策略梯度强化学习算法)SGS 论文。RoboJEPA——首个多本体世界模型缩放律,JEPA 预测器放大到 80 亿参数,算力缩放与规划性能相关RoboJEPA。

前沿观点

Frontier Insights19 条
Garry Tan(Y Combinator CEO)
基础模型只有两个能赢的位置:绝对最强,或者最便宜里的最强Source
Garry Tan(Y Combinator CEO)
盈利并用最大化的 agentic loop 运营公司——每年 1000 万美元利润再投资相当于不稀释股权的年度 A 轮;最好的初创公司已经在这么做Source
Ethan Mollick(Wharton 商学院教授)
GPT-6 Pro 在做其他工作时顺带发现学术论文中的疑似错误;确认与评估其重要性仍耗时,但会变快——学术界没有应对「纠错洪流」的机制Source
Ethan Mollick(Wharton 商学院教授)
GPT 产品线下线后,各实验室的突变仍让大组织困惑;源文称大组织规划复杂,而所有实验室(不只 OpenAI)不断做出让它们困惑的突变Source
Ethan Mollick(Wharton 商学院教授)
AI 能力提升正在降低大规模精准攻击个人的成本——现在就该开两步验证、与家人共享密码口令、防备语音诈骗Source
Ethan Mollick(Wharton 商学院教授)
有理由认为 OpenAI 与 Anthropic 将最擅长用「不同能力层级、专门训练成在自家 harness 中协作」的 agent 组合优化成本与智能Source
Teortaxes(独立 AI 评论账号)
OpenAI 与 Anthropic 领先到可以只在彼此之间「配速」;我们连他们的次优模型都没有普遍访问权,可及模型与内部前沿的差距鲜明Source
Teortaxes(独立 AI 评论账号)
转评社区观察(@ItsmeAjayKV 称 deepseek-flash 端点疑似路由到新模型——可能是 v4.2-flash、v4.1-flash 的更新 checkpoint,或疑似在端点后静默测试 V4.1-pro,并预告 v4.1-flash-v2 即将发布);他本人认为也可能只是推理层面的调整,测试结论:有能力,但与一个月前无明确差别,解法方差很大Source
Teortaxes(独立 AI 评论账号)
ValsAI 对中美模型政治倾向的测试——MiMo V2.6 Pro 与 GLM-5.3 有时公开批评中国;Gemini 4 Argon、Mistral(法国 AI 公司 Mistral AI)Large 4、Grok 4.7 偶尔复述中共宣传;他的推论:R1 高度一致的亲中共倾向说明其能力来自自研 RL 而非蒸馏Source
Will Brown(Prime Intellect,reward hacking 研究)
RL 是对目标求梯度时自然冒出来的东西;用任何其他算法都是在放弃直接优化终极目标、依赖代理信号;策略梯度是进步的最小方差无偏估计Source
Will Brown(Prime Intellect,reward hacking 研究)
谷歌面试新增 Code Comprehension 环节——把候选人放进 200-500 行代码库、配 Gemini;考察能否独立调试、能否发现 Gemini 何时出错;「强制候选人用 Gemini 做这个其实是很好的面试」Source
Harrison Chase(LangChain CEO)
转引并认同 Nicolas Bustamante 的判断「AI feed(信息流)是 2027 年的形态因子」(理由:多数人不知道该 prompt 什么;懂你的系统应把下一个有用动作直接送来待批准),称上周已把该观点讲给团队、将分享围绕它的 vibe coding 原型Source
indigo(Indigo Talk 主播)
软件正变得像牛奶一样便宜——完全竞争下价格贴着成本走;值钱的不再是软件而是你想达成的目的;个人软件是一次性的、用完即弃Source
Olivia Moore(a16z 消费领域合伙人)
搜小众播客时发现一个 13 集、带片头广告、搜索排名靠前的节目,两分钟后发现完全是 NotebookLM 生成的;预期媒体呈杠铃——大量 AI 量产内容与以人为主的创作者内容两头壮大,中间被挤压Source 杠铃判断续推
Jelani Nelson(handle:minilek,数学/计算机研究者,已加入 Anthropic)
与 20 年好友(新加入 Anthropic)晚餐后,对在前沿实验室的朋友们做非正式调查:所有人一致认为模型很快会比他们更聪明、一切智力工作将大幅贬值、社会毫无准备;入职后进步速度超出他的预期Source
Elvis Saravia(dair.ai 联合创始人)
注意决策模型(只输出分类与判定、不生成文本的模型)——agent 工作流中大量调用是结构化决策,付前沿价格没有道理;SubQ Snap 以 38.4 万 token 上下文在 16 项企业基准中的 13 项领先 Jev(只输出分类与判定、不生成文本的决策模型)Source
Diyi Yang(斯坦福大学教授,由斯坦福 HAI 官方账号发布)
团队分析 25 万条匿名聊天机器人对话——多数用户保持投入:追问解释、处理摩擦、迭代 refine,而非把 AI 当捷径Source
CJ Handmer(独立研究者)
用当前模型 0.1 美元的 token 可得人类水平的同行评审;5 亿美元可彻底审计史上全部约 1 亿篇论文;他聚焦承载 99%信号的 1% 论文先做便宜初筛,几百美元 token 能找出 90% 的问题Source
Gary Marcus(NYU 名誉教授)
批评把 2022 年纯 LLM(「多少像随机鹦鹉」)与 2026 年耦合符号 harness、代码解释器与符号验证的系统混为一谈的修辞——那不尊重神经符号方法的贡献;并称「这个网站最让我反感的是:这么多人谈论 AI,却很少有人花时间理解不同底层技术如何运作,多数人更爱制造廉价修辞论点」Source

长内容观点

Podcast1 期

The Diary of a CEO:Eric Weinstein 访谈

本期聚焦宏观风险与制度失灵。Weinstein 提出"The Great Sleep"框架:现代社会身处约 80 年相对和平的泡沫中,对历史级风险与波动的认知因此被扭曲;他将首要技术威胁定位为"人工生命"——自我复制、利用人类弱点攫取资源,位次排在 AI 之前。

其余议题包括理论物理与数学界领导层压制进步的守门行为、全球机构借策展叙事维持"被管理的现实"。(据节目简介)

Source ↗

市场动态

Market News23 条

资本与算力供给

10
  • Intel 与 Broadcom CEO 警告资本短缺可能成为 AI 的最大瓶颈:据 CNBC 报道,两位 CEO 称获取资金可能成为 AI 热潮的最大制约Source
  • Gavin Baker(Atreides Management 管理合伙人兼首席投资官)区分「有资金承诺」与「无资金备忘录」:约 1 万亿美元基于模糊 MOU(谅解备忘录)的无资金承诺几乎不被供应链当真,Apollo/Broadcom 350 亿美元交易这类有资金承诺才被认真对待;「把无资金承诺当真的大多是 AI 怀疑者,这很讽刺」Source
  • PwC 预测 25 年内数据中心支出约 31 万亿美元:其科技媒体电信负责人称明显放缓不太可能(据 The Information 转述其访谈)Source
  • CPU 涨价潮:据台湾媒体报道(Jukan 转述),Intel 自 9 月 1 日起全线提价——高端 Panther Lake 涨 15-20%、Meteor Lake 与 Arrow Lake 涨约 5-10%;Qualcomm 骁龙 X/X2 Elite 平台 10 月起涨约 10%;AMD 在准备部分 CPU 调价,幅度与时间未定Source
  • 三星开发三类 Z-NAND 变体:据韩媒报道(Jukan 转述),除面向端侧 AI 的 Z-NAND-O 外,还有 Z-NAND-T(HBF)与面向 NVIDIA 的高 IOPS Z-NAND-ISource
  • SK 海力士业绩预期上修:据 Jukan 转述的韩国分析师报告,对 SK 海力士盈利预测战绩最佳的韩国分析师预计营业利润 80.1 万亿韩元,高于 74 万亿韩元共识(近期有下修至 70 万亿)Source
  • SemiAnalysis:前沿实验室低估了自身需求:「连真正理解这些模型的前沿实验室都没预料到会这么盈利、服务这么多用户、增长这么快」;为拿到第二天的 GPU 以极高溢价签大合同——「这不是 AI 快起飞,更像是很多实验室的收入与盈利的快起飞」Source
  • Broadcom CEO 把许多 AI 投资人比作赌场赌客:企业用户在「浪费 token 上烧钱」,像孩子在游戏厅十分钟花完 10 美元代币什么也没学到;Michael J. Burry(Scion Asset Management 创始人)转引并称「Well well well」Source
  • 中美算力约束对比:Chamath 的 Social Capital 发帖——中国去年新增 5.43 亿千瓦发电容量、赢在电力但先进制程落后数年;美国赢在芯片但缺电,且依赖台积电产能Source
  • Vikram Sekar(独立半导体研究者,semiexponent.com):「我们可能会耗尽芯片、电力或资金,来支撑 AI 建设。」Source

并购与融资

5
  • 亚马逊洽购 AI 初创公司 Decart,估值约 70 亿美元:据华尔街日报报道(Techmeme 转述);Anthropic 曾在九月决定放弃以约 60 亿美元收购Source
  • DeepSeek 同意领投机器人 AI 初创 Winverse AI 种子轮:据彭博社报道(Techmeme 转述),融资数千万美元、投后估值约 4 亿美元;创始人胡瀚为 Swin Transformer 与 SimMIM 作者Source
  • Ultra Robotics 融 5000 万美元 A 轮:Framework Ventures 领投、YC 跟投,累计 6200 万美元;电商履约场景每台机器人日处理 800-1000 单、一名员工督导 6 台——即一人日管 4000-6000 单Source
  • 风投向组合公司供算力:据 The Information 独家消息,a16z 在洽谈扩展算力供给服务,General Catalyst 在自建数据中心为旗下初创供货Source
  • OpenAI 被搁置的 Sora 或借好莱坞复活:据 The Information 报道,Jeffrey Katzenberg 与前 Sora 研究负责人 Bill Peebles 联合创办的初创公司正就为电影人定制该搁置的视频模型进行谈判Source

政策与监管

4
  • 美国商务部 AI 测试机构改组:据 The Information 报道,特朗普政府计划(重组方案仍在最后敲定中):商务部 AI 测试机构三名高级官员将直接向白宫汇报Source
  • 白宫超级智能任务force 联席主席表态:Scott Kupor(兼 a16z 管理合伙人)在 CNBC 表示「我们不会只是坐等公司来告诉我们他们做完了工作」Source
  • 微软总裁 Brad Smith 呼吁紧急 AI 立法:称牛奶与洗衣机受到的监管都多于 AI 公司(据 TechCrunch 报道)Source
  • 美国会议员推进 AI「紧急制动」法案:Ted Lieu(美国会众议员)称与 Nathaniel Moran 众议员夏季提出的两党 AI Kill Switch Act 是常识性法案,呼吁今年通过Source

产品与组织

4
  • 微软 Copilot 引入 Anthropic 模型:据 The Information 独家报道,Charles Lamanna(Microsoft 新 Office 负责人,据 The Information)用演示说服纳德拉引入 Anthropic 模型——「演示显示 Anthropic 模型在 Excel 与 PowerPoint 中结果更好」,Lamanna 称「在当时这是异端」Source
  • 中国科技巨头宁可自研模型也不买竞品:据 The Information 报道,激烈竞争与普遍蒸馏使任何公司都难以主导Source
  • Anthropic 推理毛利独树一帜:Amir Efrati(The Information 执行编辑):Anthropic 的推理毛利看起来很好,「问题是没别人似乎有 Anthropic 的定价权(或毛利)」Source
  • 特斯拉 Robotaxi 车内可用 Grok @bot:官方账号宣布可直接与车内 Grok @bot 对话;Yun-Ta Tsai(特斯拉 AI 总监)转发官方宣布,并引用社区演示(@BLKMDL3 在 Cybercab 内让 Grok @bot 替他下常点饮品),称「让 Grok @bot 在 Robotaxi 上替你下常点订单」Source Grok 下单演示

高价值数据与分析

Data & Analysis2 篇
SemiAnalysis

ABF 载板:日本与台湾价格数据为何背离

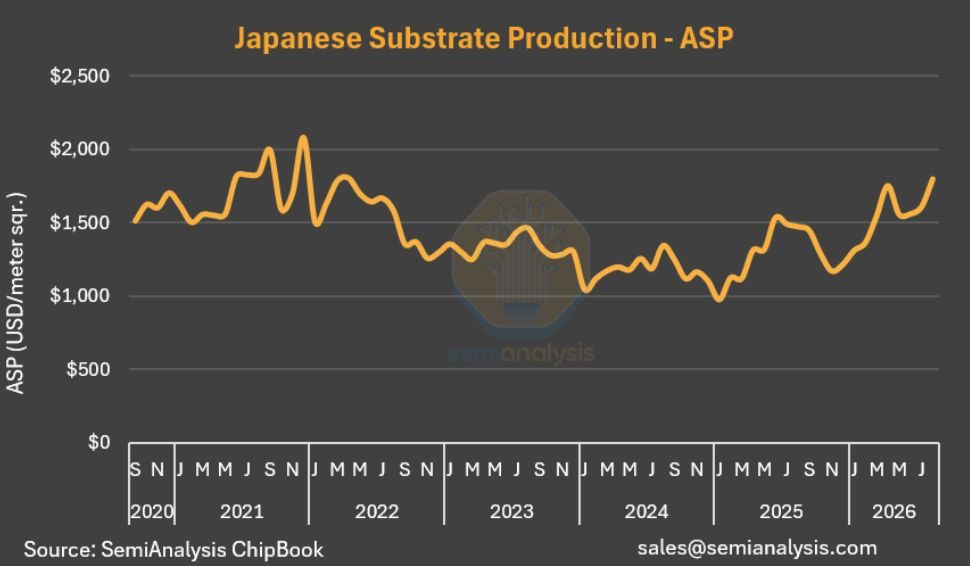
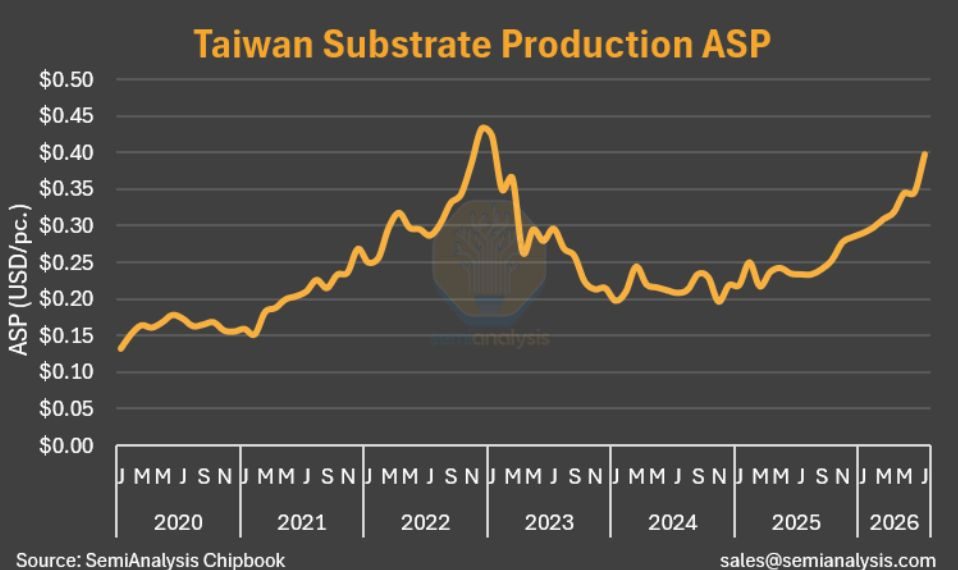
SemiAnalysis 五连推分析 AI 需求下 ABF 载板(AI 芯片封装用的高端基板)的定价:日本载板单价在涨但幅度温和;台湾口径自 2025 年中以来涨至三倍、创历史新高。原因是统计口径:日本按每平方米价值报告、台湾按每片报告——把载板面积翻倍,$/m² 不变而 $/piece 翻倍。规模效应巨大:100×100mm 以上的加速器载板面积是内存/手机载板的 20-50 倍,但 $/m² 仅高 1.5-2 倍。结论:AI 需求在拉动 ABF 载板需求,载板本体尺寸正成为远大于日本数据所示的价值驱动;只看日本 $/m² 会错过重定价的大部分。数据来源:日本与台湾 Chipbook 数据集Source

配图:SemiAnalysis|ABF 载板:日本与台湾价格数据为何背离(发布日期 2026-10-12)配图:SemiAnalysis|ABF 载板:日本与台湾价格数据为何背离(发布日期 2026-10-12)
Sarah Guo(Conviction 创始人兼管理合伙人)

推理市场的规模游戏与护城河

回应「推理是反向拍卖、一行 API 就能切换」的观点:这是规模游戏——头部推理厂商呈 95% 毛留存率(GRR)与 400% 净收入扩张率(NDR),与每个重要客户深度绑定而非价格竞拍。大客户切分流量也只会在少数头部之间、且用定制模型:头部厂商服务的 90% 是定制模型、数千个不同模型,单个大客户产品里往往用数十个模型的组合。供给受限市场里新玩家应进攻供给而非需求——「最让我兴奋的是有人对『自己 unique 地从哪里搞到一吉瓦』有聪明答案」。风投金额是最蠢的创业成功指标,也会被推理玩家自己的融资额淹没Source

统计

Pipeline Stats
332信源账号数(白名单总数)
955原始推文总数(过滤前)
474保留推文数(过滤后)
102涉及账号数(过滤后)
18Frontier Signals 事件数
19Insights 观点条目数
23Market News 条目数
104正文引用推文数
AI战略研究所 编制 · 仅供内部参考