10-23 补充版已报 K3.1 发布爆料。今日新增:月之暗面 10-24 正式发布 Kimi K3.1 Pro,称其为基于 K3 后训练的版本,总参数 2.8T、激活参数 104B 的 MoE 模型,上下文 1M,同时提供推理速度快 2 至 3 倍的 Highspeed 版本,开放权重将在 11 月 4 日前发布。 Kimi 技术博客 @Kimi_Moonshot X 帖
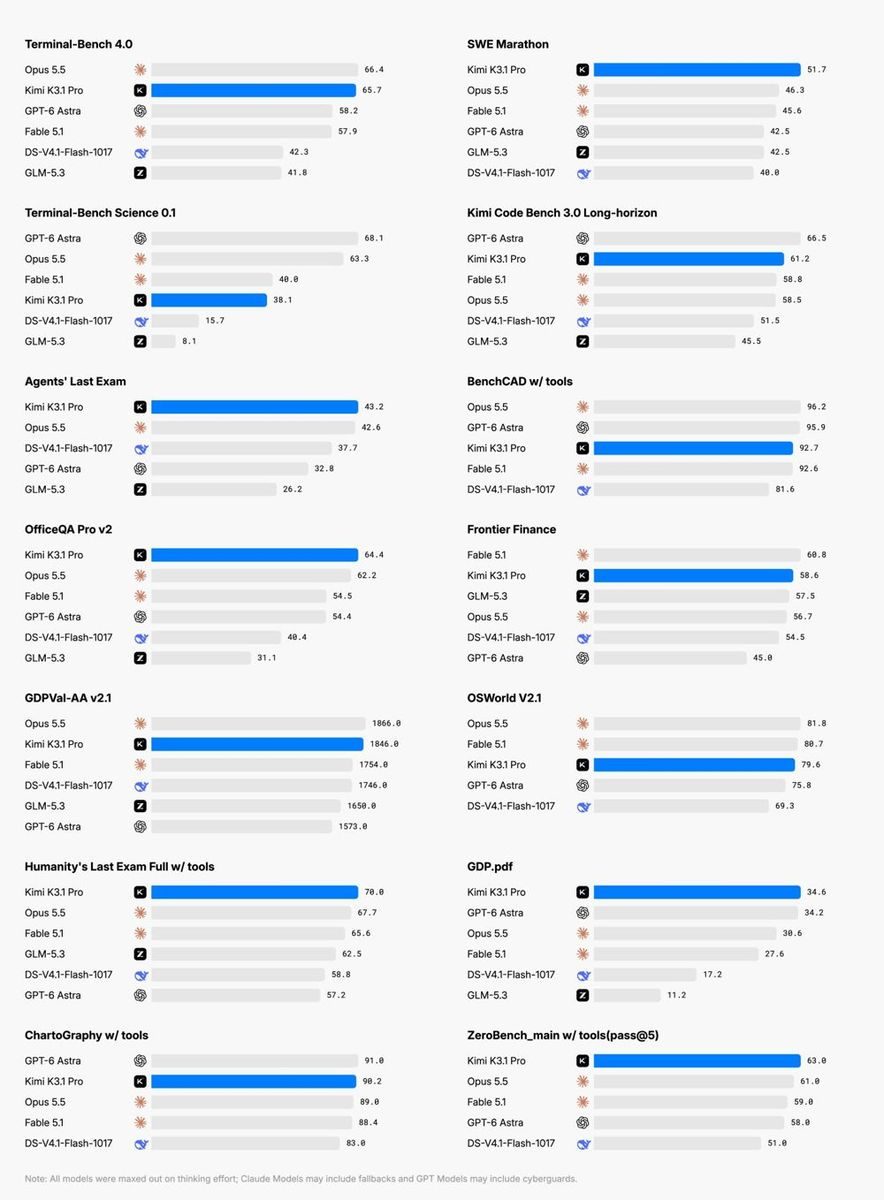
技术博客公布的自测成绩:Terminal-Bench 4.0 为 65.7%(GPT-6 Astra 58.2%,Opus 5.5 66.4%);内部长程编程基准 Kimi Code Bench 3.0 Long-horizon 从 K3 的 55.95% 升至 61.2%;内部幻觉压力测试 Kimi Hallu Bench Hard 的断言级幻觉率从 23.4% 降至 8.3%【公司自述】。 Kimi 技术博客
博客称,团队在中期训练和强化学习阶段移除了网络安全数据:未移除时 xdev-bench-hard 的 pass@3 为 90.5%,最终版本为 81.0%;博客称其网络安全能力落后于已公开至少 3 个月的前沿闭源模型。 Kimi 技术博客
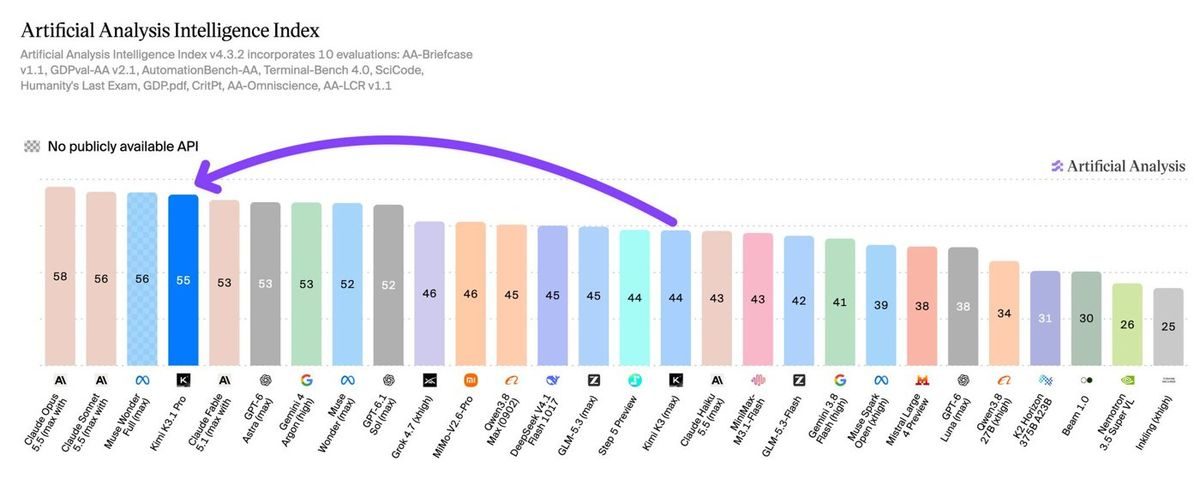
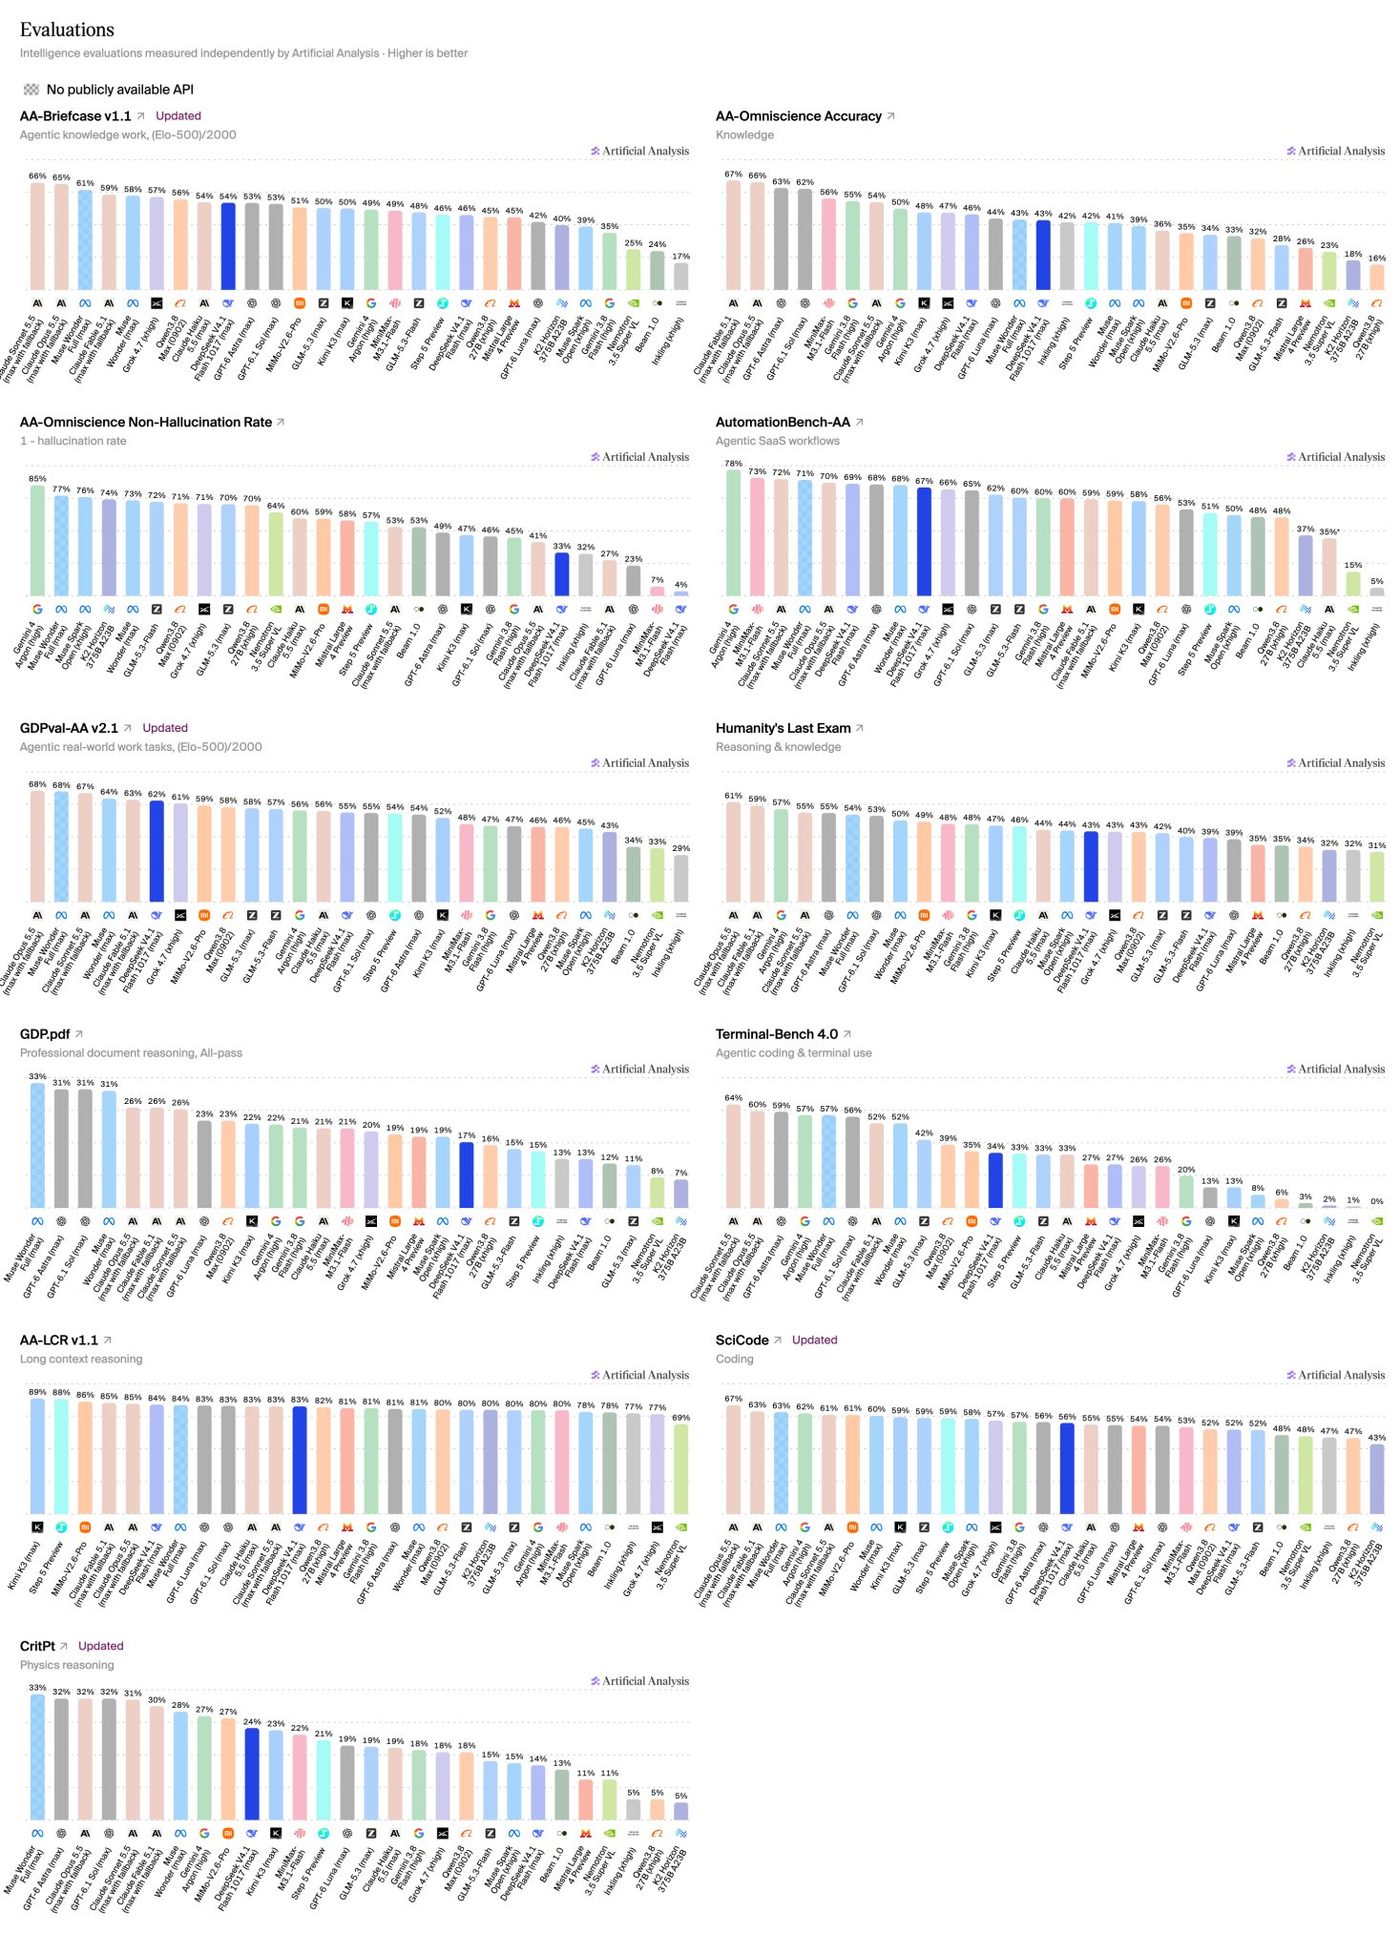
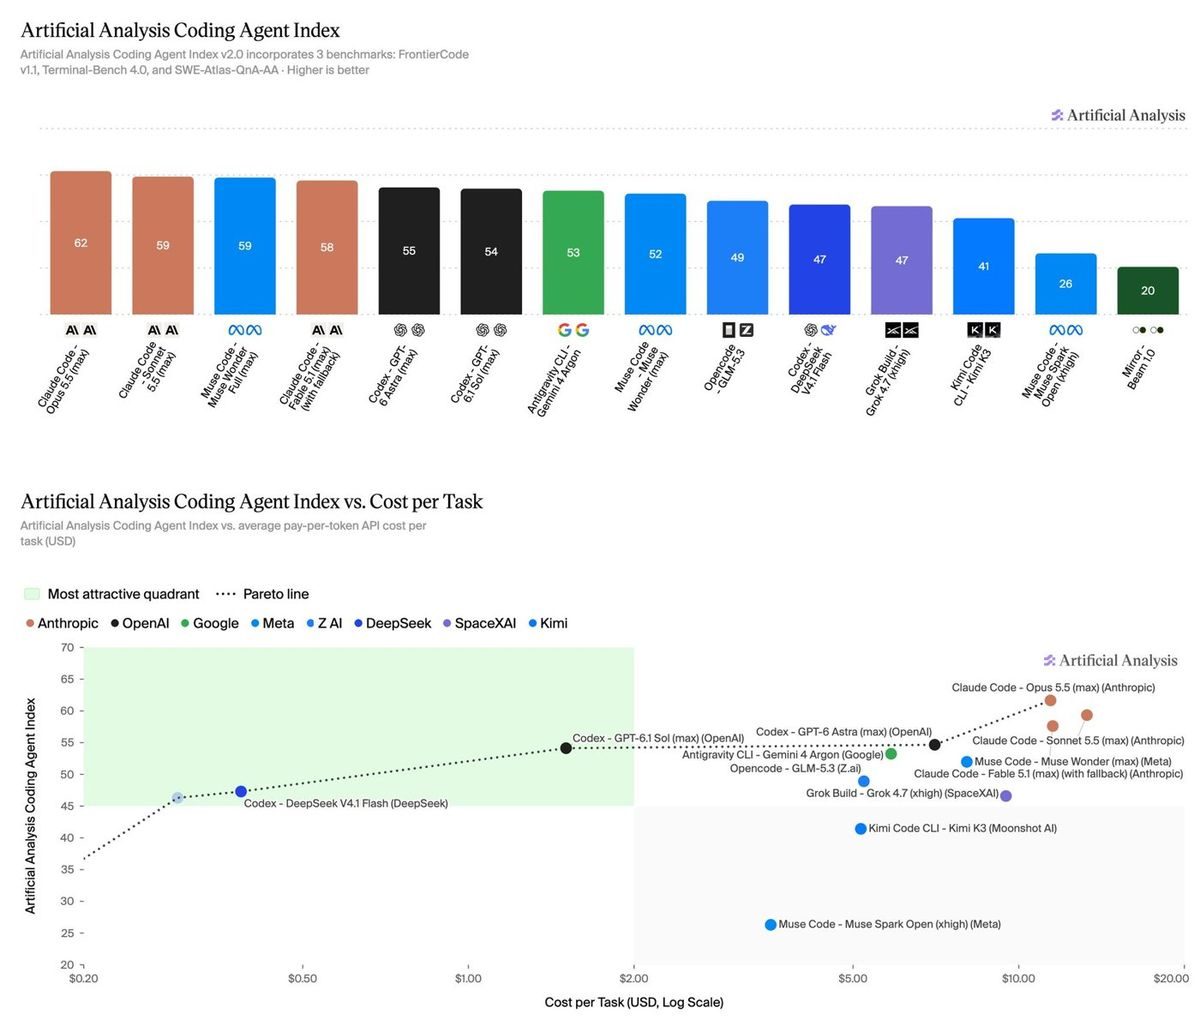
第三方评测机构 Artificial Analysis 称,K3.1 Pro 的智能指数为 55,排第 4,比 K3(44)高 11 分,仅次于 Claude Opus 5.5(58)、Claude Sonnet 5.5(56)和 Muse Wonder Full(56);同榜 DeepSeek V4.1 Flash 1017 为 45、GLM-5.3 为 45;每个任务成本约 1.98 美元,与 K3 大致持平。 @ArtificialAnlys X 帖
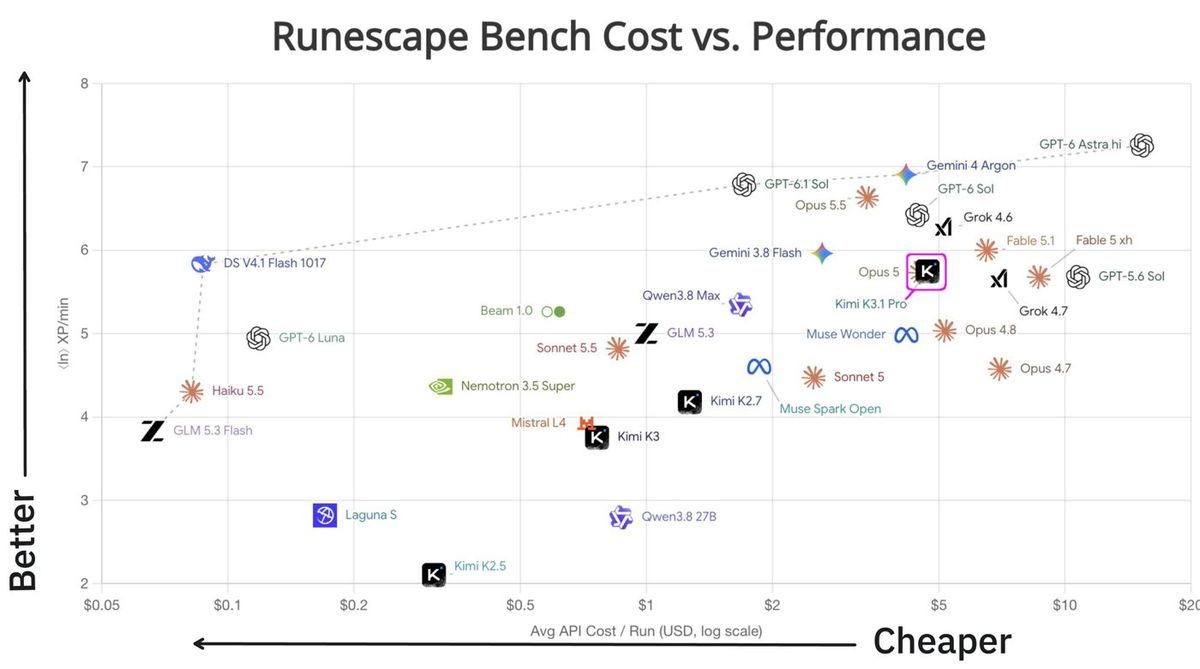
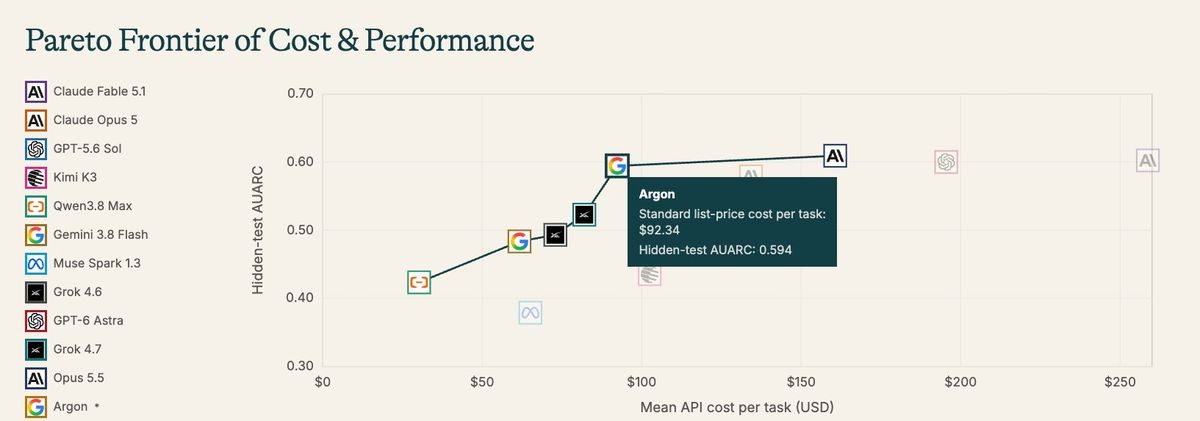
开发者 maxbittker 的 RuneScape Bench(让模型在游戏中完成任务,横轴为每次运行的 API 成本)结果显示,K3.1 Pro 成本与 Gemini 4 Argon 相当,得分与 DeepSeek V4.1 Flash 接近;maxbittker 称其水平类似 3 个月前的 Opus 5.0。 maxbittker X 帖
月之暗面发布的 Kimi K3.1 Pro 基准成绩图:14 项基准中与 Opus 5.5、GPT-6 Astra、Fable 5.1、DeepSeek V4.1 Flash-1017、GLM-5.3 的对比,蓝色为 K3.1 Pro。 原图来源:@Kimi_Moonshot 发布帖配图
@Kimi_Moonshot X 帖Artificial Analysis 智能指数 v4.3.2(含 10 项评测):K3.1 Pro 得分 55,箭头标出其相对 K3(44)的提升;格纹柱表示无公开 API。 原图来源:@ArtificialAnlys 发布帖配图
@ArtificialAnlys X 帖RuneScape Bench 成本—表现散点图:纵轴越高表现越好,横轴为对数刻度的单次运行 API 成本,越靠右越便宜。 原图来源:maxbittker 帖配图(经 @teortaxesTex 转引)
maxbittker X 帖10-23 此前:月之暗面 Kimi K3.1 据称将于 10-27 前发布,Arena 匿名代号为 Kibitz
【未证实】zephyr_z9 转发 AI 爆料账号 ChrisGPT 10-22 的 X 帖称,Kimi K3.1(在 Arena 上的代号为 Kibitz)将于下周二(10-27)前发布,是低成本的最先进开源模型;月之暗面尚未官方公布。 @ChrisGPT X 帖 @zephyr_z9 转发
同帖附带"按你心目中自己的样子在 Minecraft 里搭建"的对比测试:GPT-6 Astra 搭建 5,738 个方块、花费 5.31 美元;Kimi K3.1 搭建 13,707 个方块、花费 0.38 美元【未证实】。 @ChrisGPT X 帖
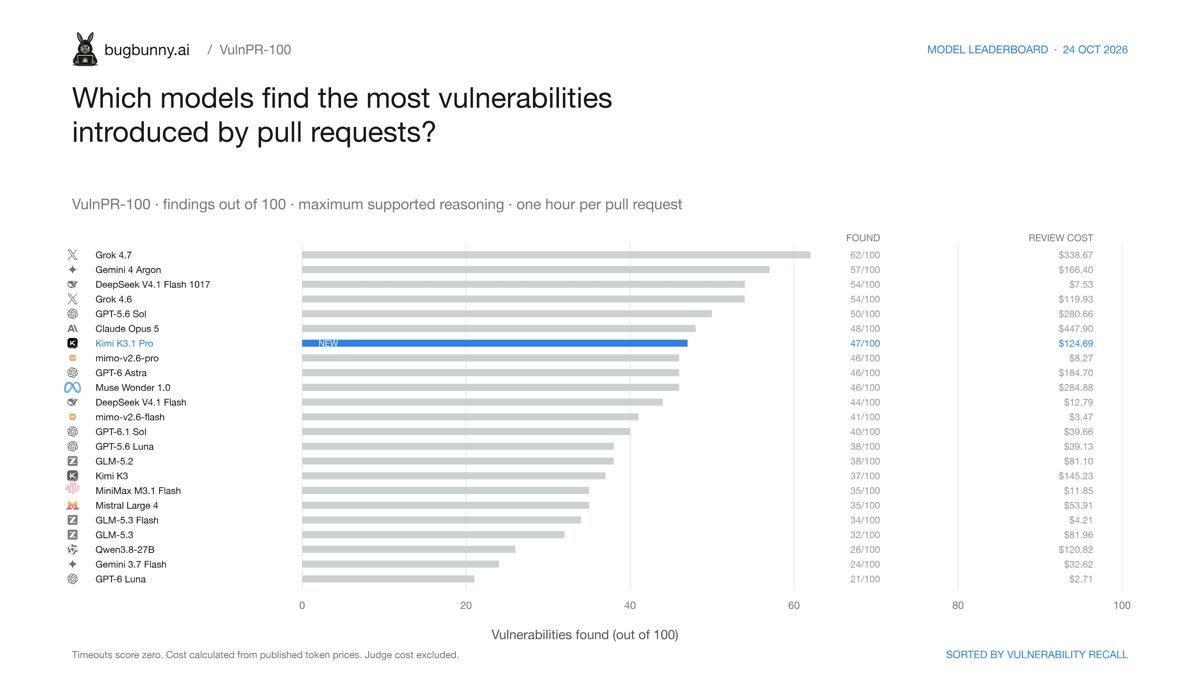
10-25 跟进:月之暗面新模型 Kimi K3.1 Pro 在代码漏洞测试中找出 47 个漏洞,比上一代多 10 个
10-24 已报 Kimi K3.1 Pro 发布,权重将于 11-04 前开放。今日新增:BugBunny(bugbunny.ai,AI 漏洞挖掘工具)维护者 Zaddyzaddy 公布 VulnPR-100 测试(找出 100 个由代码合并请求引入的漏洞),K3.1 Pro 找到 47 个,花费 124.69 美元;比上一代 K3 多 10 个,花费少 20.54 美元,单个漏洞成本由 3.93 美元降到 2.65 美元(降 33%)。他称 K3.1 Pro 超过 GPT-6 Astra 与 Muse Wonder 1.0(均为 46),比 Claude Opus 5(48 个、447.90 美元)少 1 个,成本低 3.6 倍;DeepSeek V4.1 Flash 1017 找到 54 个、花费 7.53 美元,比 K3.1 Pro 多 7 个,成本约为其 1/16.6。bugbunny.ai 官网与博客未设该测试的榜单或方法页(10-25 已查),以下数据以维护者 X 帖为准。 @Zaddyzaddy X 帖
榜单图显示,Grok 4.7 以 62/100 居首(338.67 美元),Gemini 4 Argon 57/100 第二;小米 mimo-v2.6-pro 找到 46 个、花费 8.27 美元;K3.1 Pro 在 23 个模型中排第 7(本报按图中排序统计)。 @Zaddyzaddy X 帖
VulnPR-100 榜单(10-24):每个合并请求限时 1 小时、最高推理档,按找到的漏洞数排序,右列为按公开价格计算的评审成本 原图来源:Zaddyzaddy X 帖
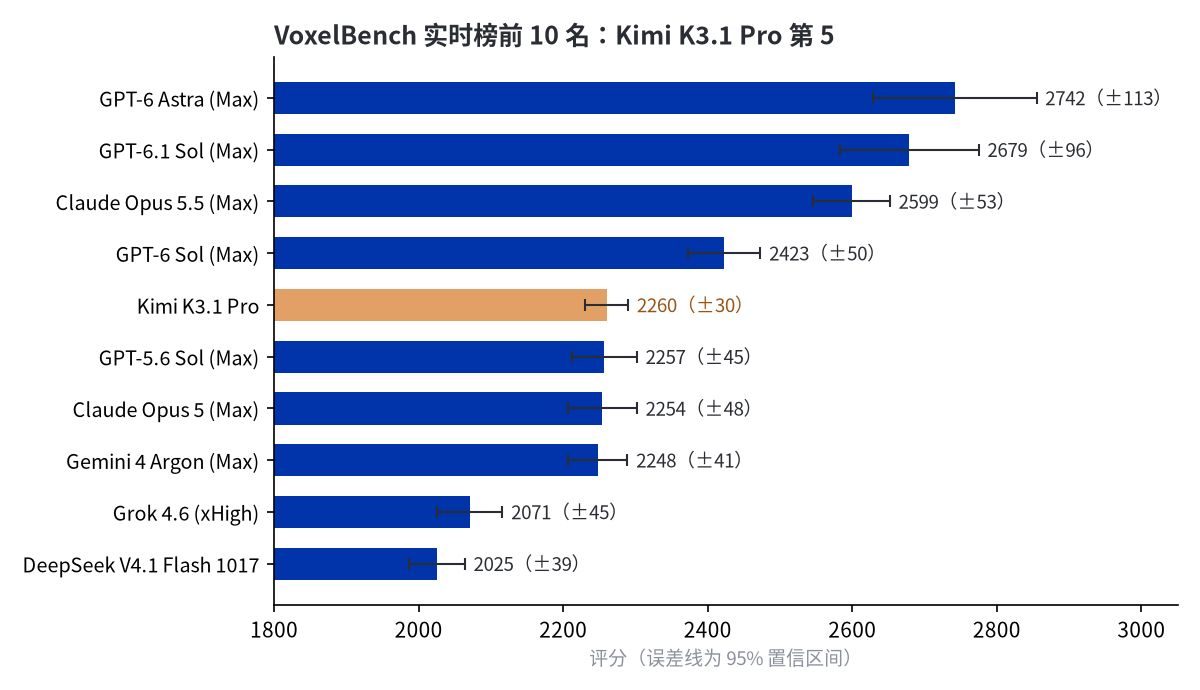
@Zaddyzaddy X 帖VoxelBench 官方实时榜前 10 名评分及 95% 置信区间(10-25 10:22 查询),橙色为 Kimi K3.1 Pro 数据来源:VoxelBench 官方实时榜单(本报自制)
VoxelBench 官方榜单